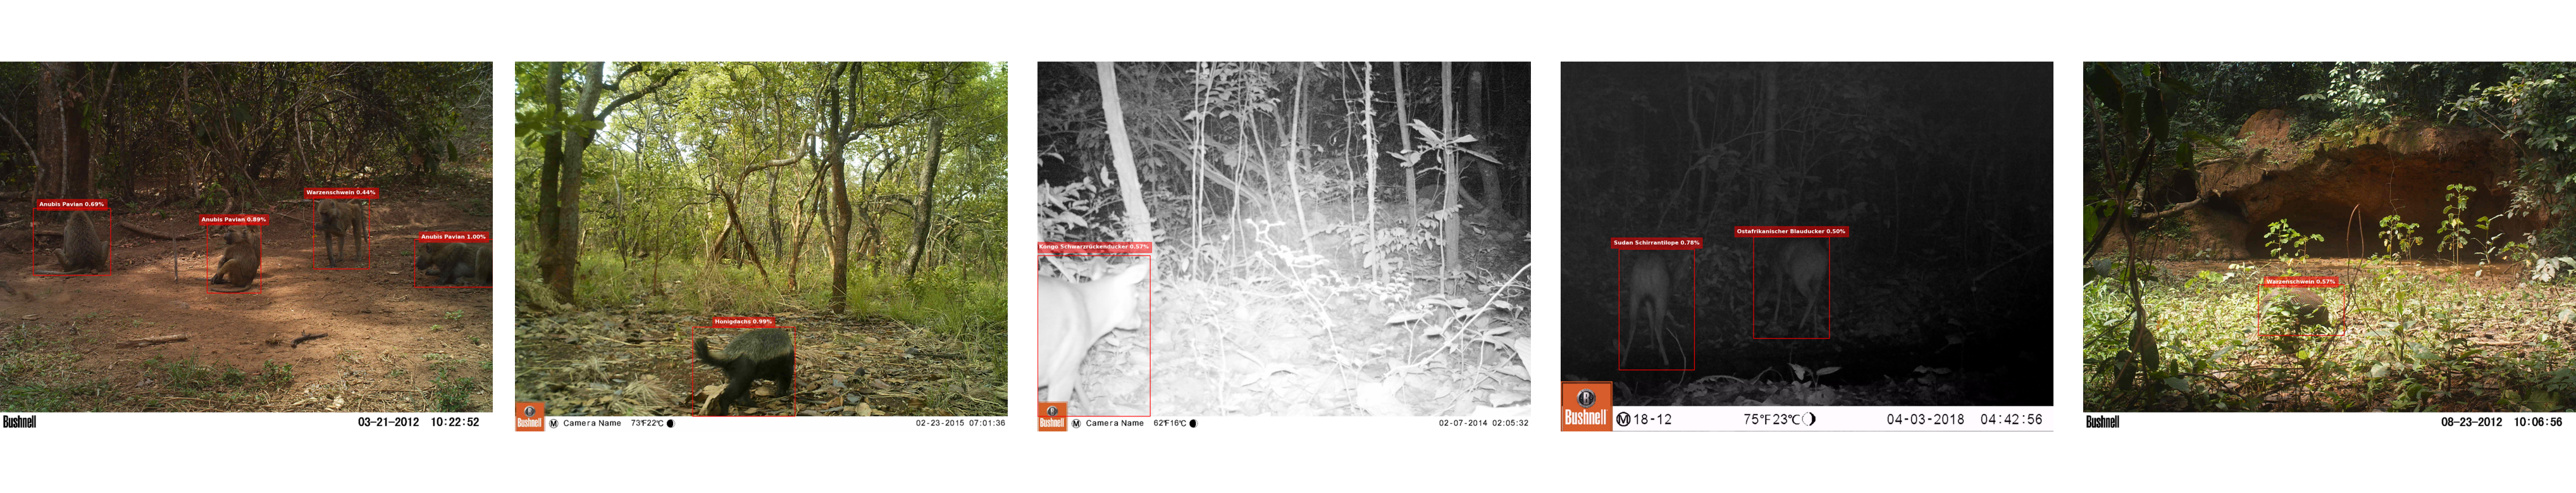
Die Arbeit untersucht die Verwendung von Deep Learning Methoden auf den von der Universität Fribourg zur Verfügung gestellten Daten bestehend aus Kamerafallenbilder. Für diesen Zweck wurde die Datenqualität analysiert und eine Pipeline zur Klassifikation der Spezies erstellt und trainiert.
Python, Deep Learning, Camera Traps, Supervised Learning, Image Classification, Object Detection
Die Tatsache, dass seit geraumer Zeit die Biodiversität in der Wildtierpopulation abnimmt und deren natürlichen Lebensräume schrumpfen, ist bekannt. Darum ist das Beobachten und das Verstehen der Entwicklung von Wildtierpopulationen ein wichtiger Bestandteil der heutigen Forschung. Für die Erforschung von Wildtierpopulationen werden bewegungssensitive Kameras, sogenannte Kamerafallen, eingesetzt. Sobald sich ein Tier in der Detektionszone einer Kamerafalle befindet, werden durch einen integrierten Infrarotsensor die Bewegungen detektiert und der Auslöseprozess getriggert.
In den letzten Jahren hat sich durch den Einsatz von Kamerafallen das Verständnis über ökologische Beziehungen und Wildtierpopulationen stark verbessert. Durch den vermehrten Einsatz von Kamerafallen steigerte sich die Anzahl der Bilder drastisch. Mit Hilfe der Bilder können beispielsweise die Anwesenheit von Tieren, deren Identifizierung der Spezies und Erkennung menschlicher Aktivitäten analysiert werden. Die immense Anzahl an aufgenommenen Bilder generiert einen grossen Aufwand für die manuelle Auswertung. Der Auswertungsprozess ist ausgesprochen aufwändig und schlägt sich auf die Produktivität der Forscherinnen und Forscher in diesem Bereich nieder. Dazu kommt, dass circa 70% der vorhandenen Bilder fälschlicherweise ausgelöst werden. Der Einsatz von Machine Learining könnte die manuelle Verarbeitung der Bilder reduzieren und den Prozess effizient und effektiv gestalten.
Die Analyse dieser Bilder kann durch Machine Learning, insbesondere durch Deep Learning Modelle, teilweise vollständig automatisiert werden. Die Leistung von Deep Learning Modellen ist jedoch unterschiedlich und kann stark von den Tierarten und Lebensräumen abhängen. Die Universität Fribourg verfügt über einen Datensatz mit knapp 3 Millionen Kamerafallenbilder, von denen ca. 1,2 Millionen von Hand annotiert wurden. Der Datensatz wurde im Chinko-Naturreservat in der Zentralafrikanischen Republik gesammelt und deckt eine grosse Vielfalt von Lebensräumen und Spezies ab.
In einer Zeitspanne von 19 Seasons (7 Jahre)u nd mit Bildern aus 520 verschiedenen Kamerastandorten wurden 293 verschiedene Spezies auf den Bildern erkannt und annotiert. Eine Untersuchung der Datenqualität nach Übereinstimmung mit der Annotation und dem Bildinhalt ergab, dass 14% der Annotationen fehlerhaft sind. Ein Problem ist unter anderem die Inkonsistenz in der Kennwort-Spezies-Tabelle, da für mehrere Spezies redundante Kennwörter verwendet wurden. Diese Bilder wurden aus dem weiteren Modellierungsprozess entfernt.
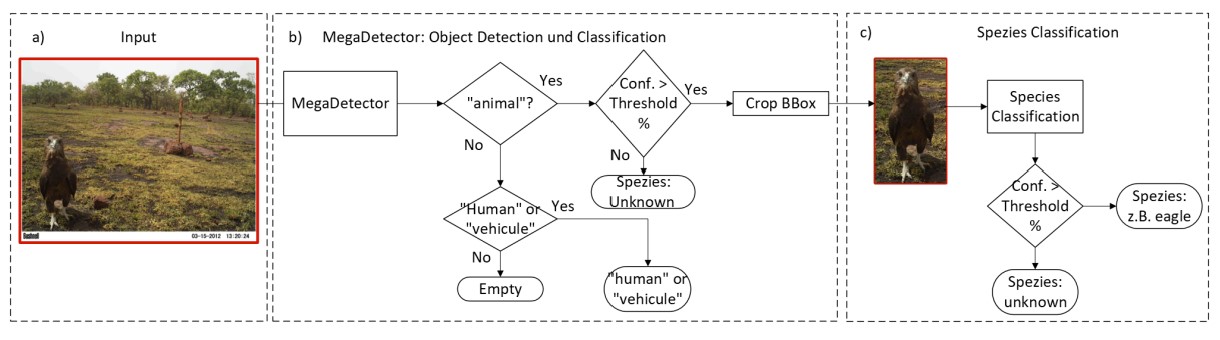
Wir verwenden eine Pipeline für die Klassifikation der Spezies. die als ersten Schritt erkennen soll, ob das Bild leer oder nicht leer ist (“empty or not empty“). Danach werden bei den Bildern, die nicht leer sind, die Spezies durch ein generisches Objekterkennungsmodell (MegaDetector) ausgeschnitten. Eine Analyse der Datenqualität in Bezug auf die Zielvariable “empty or not empty“ stellte heraus, dass wir 5% fehlerhafte Annotationen in unserem Datensatz haben. Für die Vorhersage dieser Zielvariable erreichten wir eine Accuracy von 89.7% ±5% mit dem besten Modell.
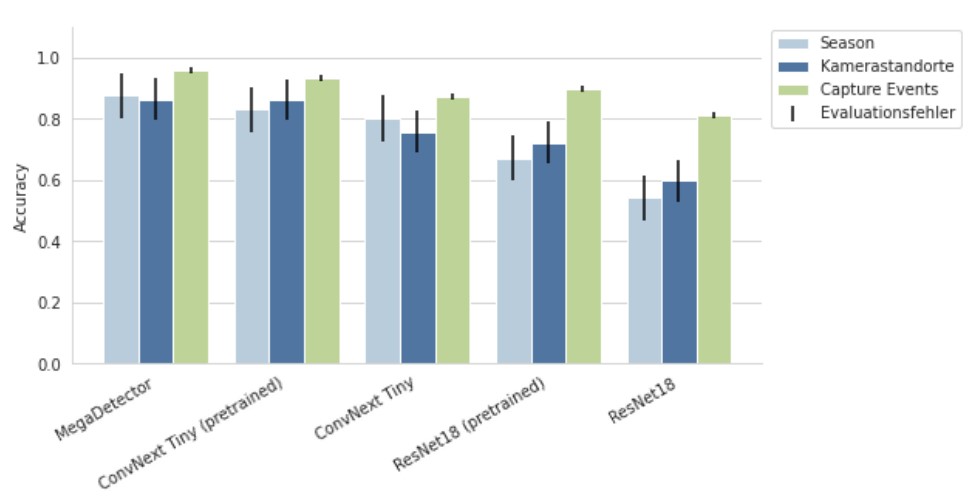
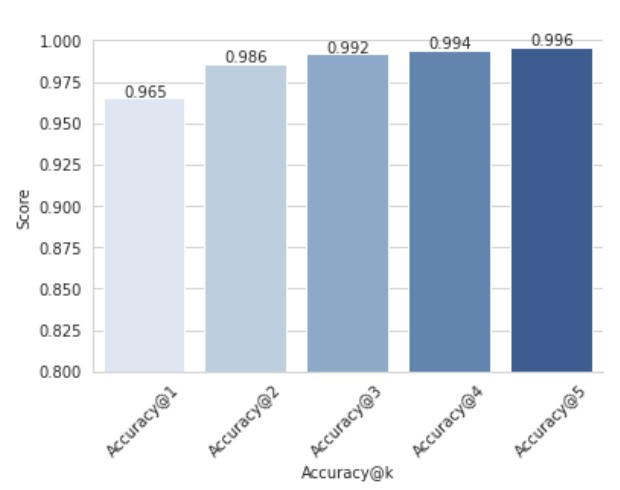
Das zweite Modell bezieht sich auf die Klassifikation der Zielvariable Spezies. Die Analyse der Datenqualität in Bezug auf die Zielvariable Spezies zeigt, dass wir einen Evaluationsfehler von 2% miteinbeziehen müssen. Nach ausführlichen Schritten zur Säuberung der Daten blieben 73 Spezies übrig, welche für die Klassifikation der Spezies genutzt werden. Die besten Modelle erzielten sehr gute Resultate bezüglich der Metriken. Das beste Modell erreichte eine Accuracy von 96.5%±2%.
Projektdauer: 1 Semester
Aufwand in Personenstunden: 360h
Teamgrösse: 2
Michael Graber, michael.graber@fhnw.ch
Marco Willi, marco.willi@fhnw.ch
Firat Saritas, firat.saritas@students.fhnw.ch
Simon Stähli, simon.staehli@students.fhnw.ch
Michael Graber, michael.graber@fhnw.ch
Marco Willi, marco.willi@fhnw.ch