
Automatisiertes Auswerten von App-Reviews gemäss dem Sustainability Awareness Framework (SusAF)
Moderne Software wirkt sich auf weit mehr aus als nur ihre Kernfunktion. Wir vergleichen, wie gut sich diese Nachhaltigkeitseffekte automatisiert aus Nutzer-Reviews herauslesen lassen. Per klassischem Machine Learning und per Large Language Model.
Ausgangslage
Eine Navigations-App verkürzt Reisezeiten, verstärkt aber gleichzeitig die Abhängigkeit vom Auto. Eine Social-Media-App verbindet Menschen, kann aber zu psychischen Belastungen beitragen. Solche Nachhaltigkeitseffekte moderner Softwaresysteme reichen weit über die reine Funktionalität hinaus. Das Sustainability Awareness Framework (SusAF) erlaubt es, genau solche Effekte entlang fünf Dimensionen – Individual, Social, Economic, Environmental und Technical – systematisch einzuordnen. Bisher kommt SusAF vor allem in Experten-Workshops während der frühen Entwicklungsphase zum Einsatz. App-Reviews bieten dagegen eine kontinuierlich verfügbare Datenquelle, die zeigt, welche Nachhaltigkeitseffekte Nutzerinnen und Nutzer im bereits produktiven Betrieb tatsächlich erleben. Die manuelle SusAF-Kodierung dieser Reviews ist jedoch zeitintensiv und skaliert nicht auf grosse Datenmengen.
Zielsetzung
Diese Arbeit untersucht, welcher technische Ansatz sich am besten eignet, um Reviews automatisiert nach SusAF zu kodieren, und wie effektiv er ist. Dazu wird ein ML-basierter Ansatz (TF-IDF, BERT, RoBERTa) einem LLM-basierten Ansatz mittels Prompt Engineering gegenübergestellt. Ergänzend wird untersucht, wie sich eine durchgängige Pipeline gestalten lässt, die rohes Nutzerfeedback vollautomatisiert in einen strukturierten Sustainability-Datensatz überführt, und ob Softwareentwicklerinnen und -entwickler einen Mehrwert erfahren, wenn sie diese Auswertungen über eine Webapplikation einsehen können.
Ergebnisse
Im direkten Vergleich erzielt der ML-Ansatz (BERT-base) die höchste Übereinstimmung mit der menschlichen Referenzkodierung, benötigt dafür aber ein trainiertes Modell und eine eigens erstellte Ground Truth. Der LLM-Ansatz kommt dagegen vollständig ohne Training aus und lässt sich bei Änderungen am Kodierschema sofort anpassen. Die Kodierqualität bleibt dabei aber hinter dem ML-Ansatz zurück. Der Vergleich zwischen einem leistungsstarken Cloud-Modell und einem lokal betreibbaren Modell zeigt zudem einen klaren Trade-off: Das Cloud-Modell liefert die verlässlicheren Ergebnisse, während das lokale Modell deutlich schneller antwortet, keine laufenden Kosten (Tokens) verursacht und gemäss Literaturschätzungen spürbar weniger Energie pro Anfrage benötigt. Dafür aber bei komplexeren Prompts an Genauigkeit einbüsst.
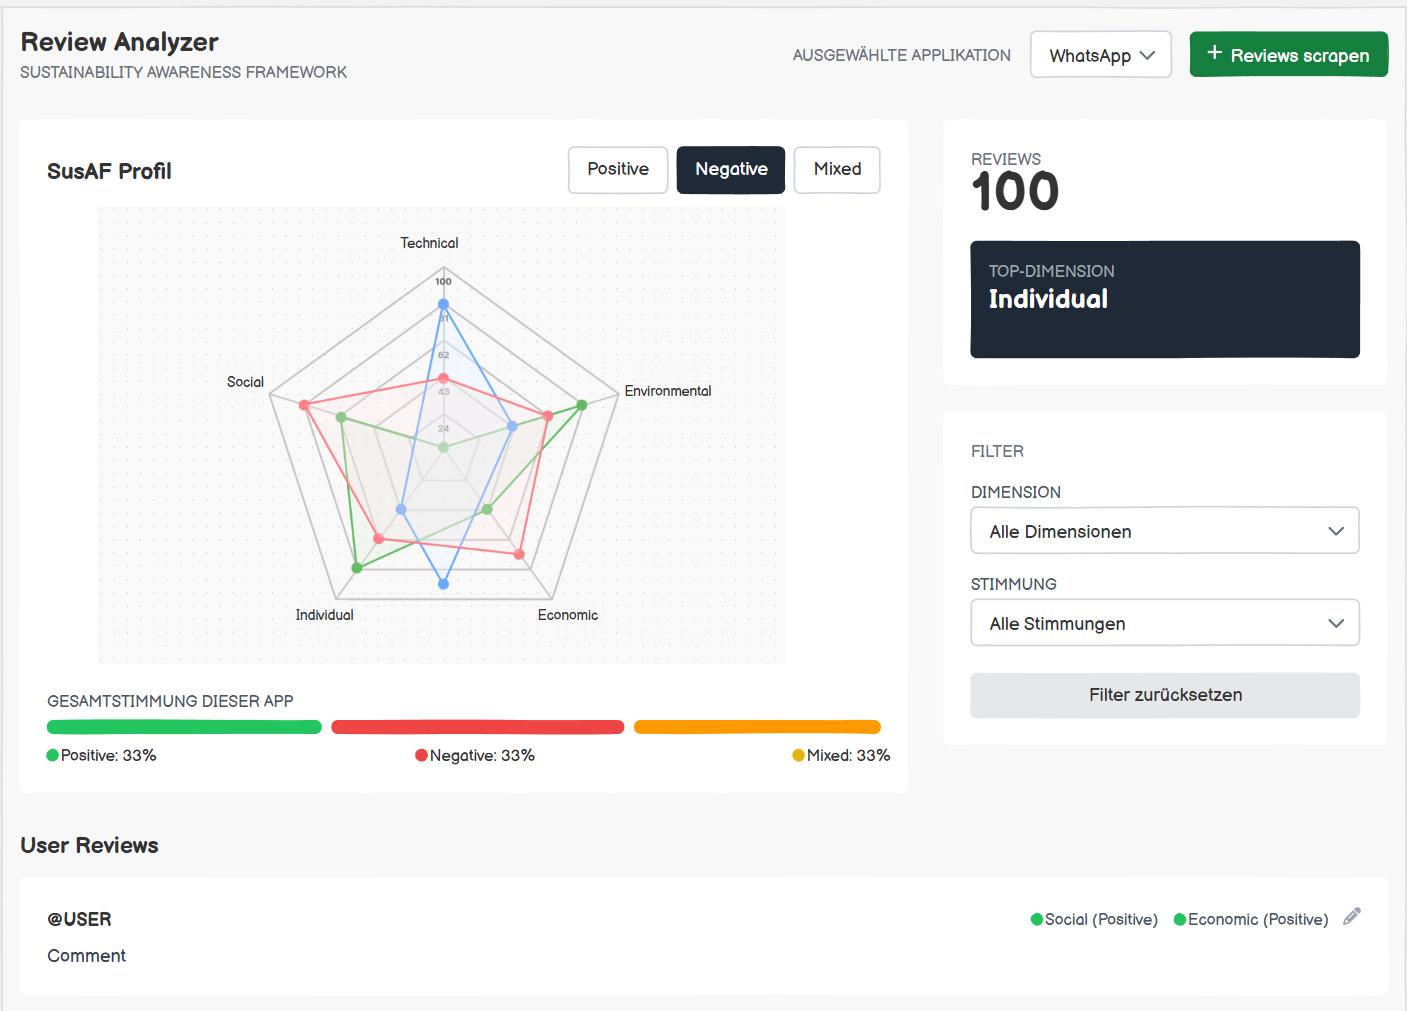
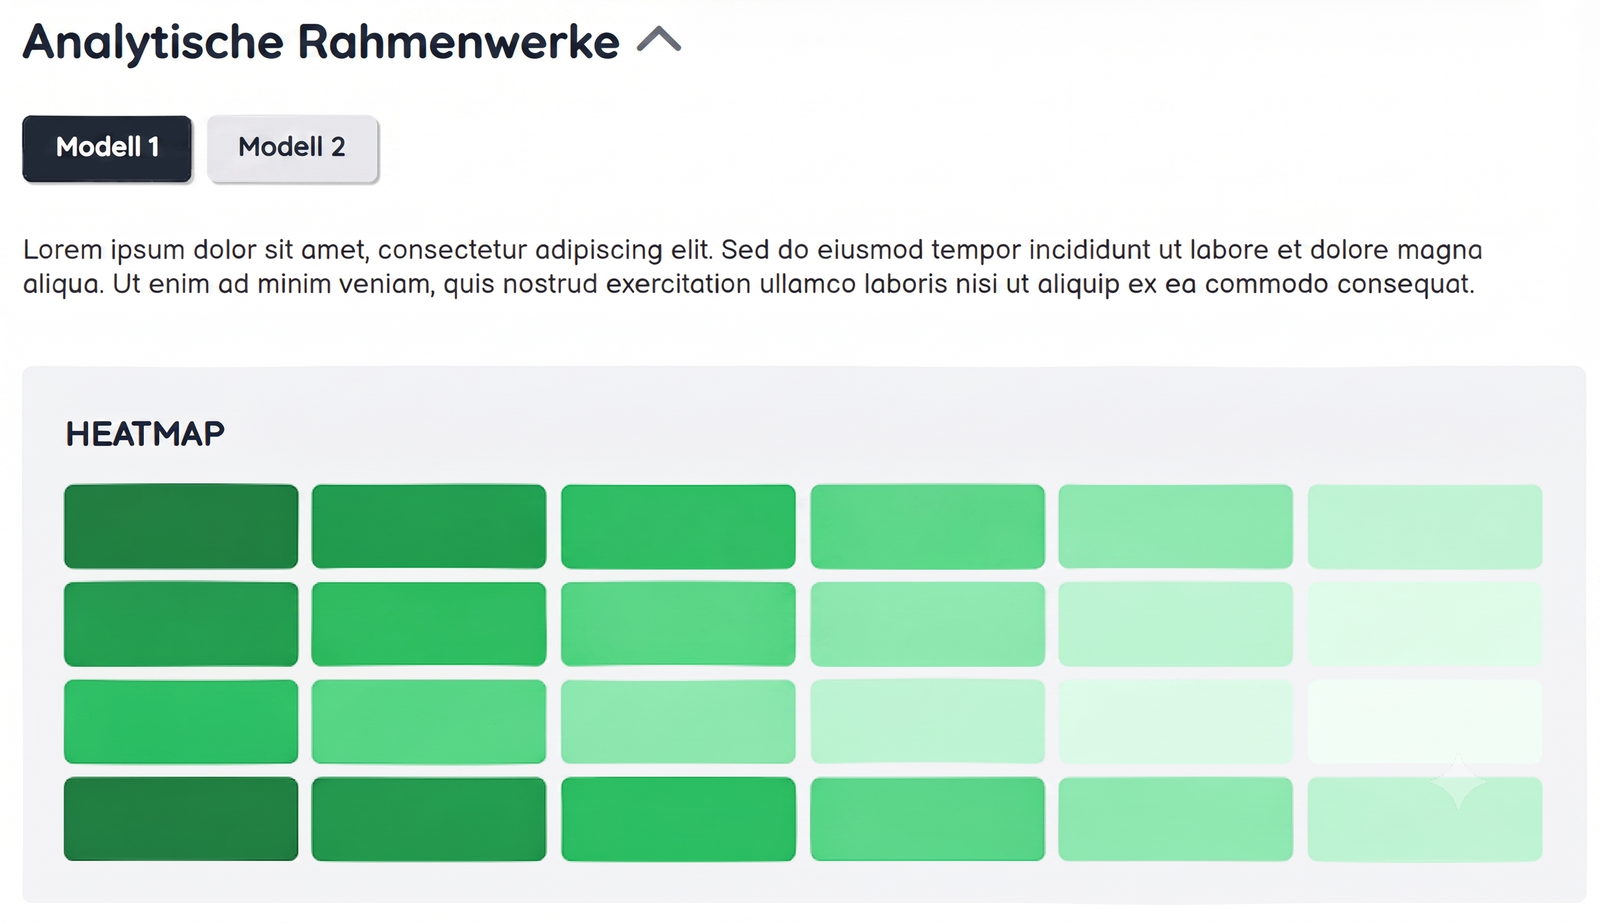
Aufbauend auf diesen Kodierungen wurden zwei Analytische Rahmenwerke entwickelt: das Sustainability Risk Profile (SRP), ein gewichtetes Scoring-Modell für ein vergleichbares Risikoprofil pro Applikation, sowie die Dimension Co-occurrence Matrix (DCM), welche sichtbar macht, welche Nachhaltigkeitsdimensionen systematisch gemeinsam auftreten. Beide Modelle wurden in einem Prototyp, dem Review Analyzer, für Softwareentwicklungsteams visuell aufbereitet. Eine Entwicklerbefragungen zeigen, dass der wahrgenommene Mehrwert durchwegs positiv beurteilt wird. Befragte berichten von Effizienzgewinnen durch die Visualisierung sowie einer gezielteren Priorisierung von Nachhaltigkeitsproblemen.
Technische Schlüsselbegriffe
- FrameworkSustainability Awareness Framework (SusAF)
- Machine LearningTF-IDF, BERT, RoBERTa (Fine-Tuning)
- Large Language ModelsPrompt Engineering, Few-Shot, Chain-of-Thought
- DomäneRequirements Engineering, App-Review-Mining
- WebapplikationReview Analyzer (Visualisierung & Analyse)
Team
Dominik Kolar, Nico Nagl
Betreuer
Prof. Dr. Norbert Seyff
Dr. Nitish Patkar