
Semantic Segmentation mit Vision Foundation Models - ein praktischer Benchmark
Wie viele annotierte Bilder braucht ein Segmentierungsmodell?
Mit 64 annotierten Bildern erreicht ein angepasstes Foundation Model rund 92 % des Werts mit allen Trainingsdaten (Makro-mIoU, Val. binär, Forest UAV).
Der offene Webarchiv-Index Common Crawl zählt über 250 Milliarden Seiten, der Bilddatensatz LAION-5B 5,85 Milliarden Bild-Text-Paare. Auf solchen Beständen entstehen Foundation Models, vortrainierte Bildmodelle wie DINOv3 (1,7 Milliarden Trainingsbilder) oder die Segment-Anything-Reihe (gestartet mit 1,1 Milliarden Masken auf 11 Millionen Bildern), die ihre Labore frei veröffentlichen. Was in diesem Vortraining steckte, ist jedoch teils unveröffentlicht und von aussen nicht nachprüfbar.
Diese Arbeit prüft das mit einem Benchmark über acht Datensätze, sechs öffentliche und zwei private, die sicher in keinem Webtraining lagen. Wir messen, wie weit solche Modelle bei semantischer Segmentierung tragen, also der Zuordnung einer Klasse zu jedem Bildpunkt (Pixel), und vergleichen sie mit klassisch trainierten Netzen.

Die Entscheidung in 60 Sekunden
Für ein neues Segmentierungsproblem stehen drei Wege zur Wahl: Prompten (sofort einsetzbar, in Spezialdomänen begrenzt), Anpassen (LoRA macht nur 0,55 % der Parameter trainierbar) oder klassisches Trainieren (braucht deutlich mehr annotierte Bilder, bleibt bei vollem Datenbestand die Referenz).

Wie wir Qualität messen
Die Kennzahl des Benchmarks ist fg-Makro-mIoU (mIoU: mean Intersection over Union), die Überlappung von Modellvorhersage und Referenzannotation, gemittelt nur über die Vordergrundklassen. Der Hintergrund dominiert die Bilder und bleibt darum aussen vor.
Jede Zahl dieser Seite trägt zusätzlich eines von drei Auswertungsetiketten, die nie gemischt werden: Benchmark (volle Testmenge, Kachelung, thresholded_argmax, die Hauptkonvention des Projekts), Val. binär (Validierungsmenge, eine Vordergrundklasse gegen Hintergrund, Konvention der Dateneffizienz-Reihen) oder Val. Mehrklassen (Validierungsmenge, alle Klassen, Konvention der klassischen Trainingsläufe). Kachelung kostet rund 12 % relativ, und zwischen Benchmark und Val. binär liegen 6–9 %; solche Unterschiede kehren Ranglisten um. Darum vergleichen wir Zahlen aus verschiedenen Etiketten nicht miteinander.
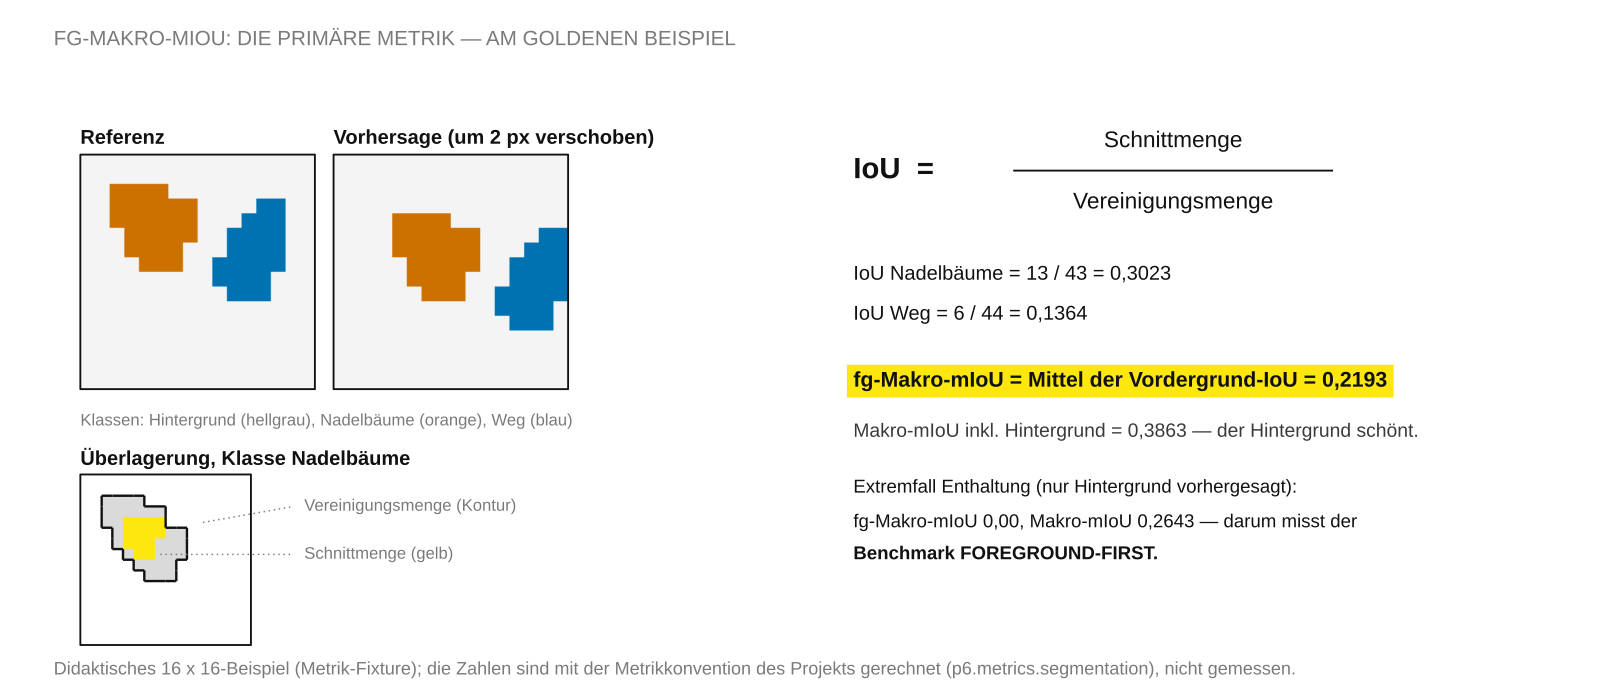
| Klasse | IoU |
|---|---|
| Hintergrund | 1,0000 |
| Nadelbäume | 1,0000 |
| Weg | 1,0000 |
| fg-Makro-mIoU (nur Vordergrund) | 1,0000 |
| Makro-mIoU (inkl. Hintergrund) | 1,0000 |
Der Weg vom Bild zur Maske
Zehn Schritte führen vom Drohnenbild zur bewerteten Maske. Mit JavaScript bleibt die Bühne stehen und die Animation folgt dem Scrollen; die Schrittleiste springt direkt zu jedem Schritt. Ohne JavaScript stehen alle zehn Schritte untereinander.
1Quellbild
Ein echter Frame aus dem Projektdatensatz Forest UAV: eine Drohnenaufnahme mit 11 annotierten Klassen. Für den Rechner ist er eine Zahlenmatrix, drei Werte je Pixel.
2Vorverarbeitung
Das Verfahren ist für alle Modelle gleich: normalisieren mit ImageNet-Statistik, dann skalieren. Die Zielgrösse ist es nicht: SAM3 erwartet 1008 × 1008, segdino-mlp Vielfache von 16, die supervised Netze 512 × 512-Kacheln.
3Kachelung
Grosse Bilder werden in überlappende Kacheln zerlegt; wie gekachelt wird, ist Teil des Messprotokolls. Kachelung kostet im Projekt rund 12 % relativ (Messergebnis, siehe Ergebnisse).
4Encoder
Jede Kachel durchläuft den Merkmalsextraktor (Encoder). Seine Basisgewichte sind eingefroren; LoRA trainiert kleine Adaptermatrizen in seinem Innern, 0,553 % der Parameter. Klassische Netze trainieren den Encoder dagegen ganz mit.
5Merkmale
Der Encoder liefert Merkmalskarten: je Rasterzelle einen Merkmalsvektor mit hunderten Kanälen. Wie grob dieses Raster ist, begrenzt die erreichbare Qualität nach oben.
6Klassenscores
Der Ausgabeteil (Decoder) liefert je Klasse ein Score-Feld; nach der Sigmoid-Funktion sind das Wahrscheinlichkeiten zwischen 0 und 1. Entschieden ist damit noch nichts.
7Zusammensetzen
Die Score-Felder der überlappenden Kacheln werden zum Gesamtbild zusammengesetzt; in den Überlappungszonen mittelt das Protokoll die Wahrscheinlichkeiten (average_probabilities), noch vor jeder Entscheidung.
8Entscheidung
Erst auf dem zusammengesetzten Feld fällt die Entscheidung: pro Pixel gewinnt die Klasse mit der höchsten Wahrscheinlichkeit; liegt sie unter 0,5, wird Hintergrund vergeben (thresholded_argmax, das Auswertungsprotokoll des Benchmarks).
9Vergleich
Die Modellvorhersage wird mit der Referenzannotation der Datensatz-Autoren verglichen: IoU Nadelbäume 0,8452 auf diesem Frame, einem Trainingsbild; darum ist es kein Val-Wert. Die Kennzahl des Benchmarks ist fg-Makro-mIoU.
10Verzweigung: dicht oder promptbasiert
Nach dem gemeinsamen Weg trennen sich die Betriebsarten: dichte Netze sagen alle Klassen in einem Durchlauf voraus, SAM3 berechnet die Bildmerkmale einmal und decodiert je Text-Prompt eine Maske.
Die Architekturen dahinter
Der Bericht stellt sechs Bauformen für dieselbe Aufgabe auf; die Schemata zeichnen sie mit gemeinsamem Block-Vokabular. Schraffierte Blöcke sind vortrainiert und bleiben unverändert, weisse werden trainiert. Jede Detailansicht lässt sich per Enter oder Klick Bestandteil für Bestandteil erkunden.
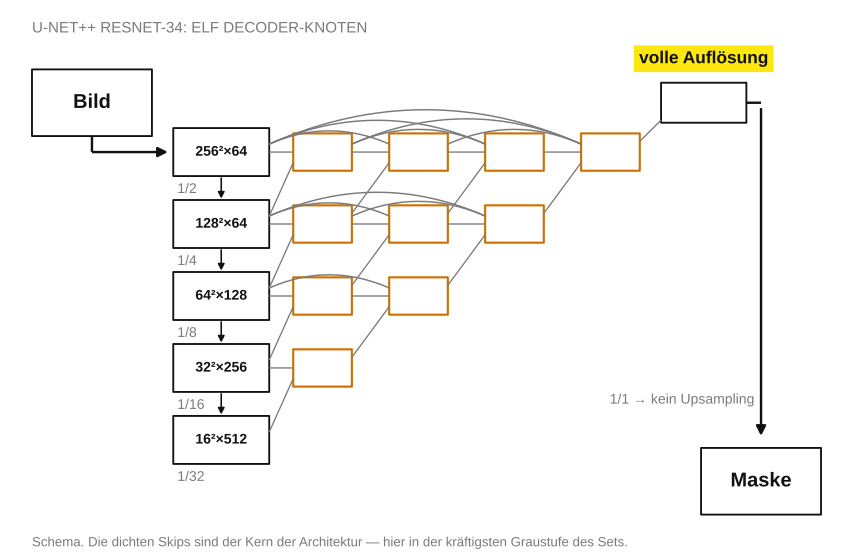
U-Net++ ResNet-34
CNN-Baseline mit dichten Skip-Verbindungen, verbreitet in der medizinischen Bildanalyse. Wird pro Datensatz vollständig trainiert.
Quelle: U-Net++, arXiv:1807.10165, verlinkt im Abschnitt Quellen.
Datensätze und Merkmalsraum
Der Benchmark deckt acht reale Datensätze aus vier Domänen ab; zwei sind privat und erscheinen ohne Bildmaterial. Die Karte zeigt jedes Bild als Embedding (DINOv3 ViT-7B/16): 984'894 von 6'215'095 Re-LAION-Webbildern als graue Wolke, dazu alle 15'106 Benchmark-Bilder, gemeinsam per LocalMAP projiziert.
Nähe bedeutet Ähnlichkeit aus Sicht des Modells, kein Qualitätsmass. Der Filter färbt den gewählten Datensatz und seine nächsten Web-Bilder (gemessen im Originalraum): Röntgen und Grundrisse haben nahe Web-Verwandte, Injection Molding und 3CAD nicht.
| Datensatz | Bilder | Zentroid x | Zentroid y | Kosinusabstand zum nächsten Web-Bild (Median) | Domäne |
|---|---|---|---|---|---|
| 3CAD | 2'500 | 0,0227 | 0,4714 | 0,5577 | Industrie |
| CubiCasa | 2'500 | 0,7509 | 0,7255 | 0,0854 | Grundrisse |
| Distal Radius | 729 | 0,1253 | 0,2272 | 0,0557 | Gesundheit |
| Forest UAV | 2'500 | 0,3176 | 0,0965 | 0,3311 | UAV |
| FracAtlas | 2'500 | 0,1029 | 0,2480 | 0,1396 | Gesundheit |
| Injection Molding | 221 | 0,1204 | 0,1490 | 0,6067 | Industrie |
| MADOS | 2'500 | 0,2388 | 0,1178 | 0,5178 | UAV |
| TE23D | 1'656 | 0,6180 | 0,2461 | 0,3984 | UAV |
Quelle: atlas_web_export_exact.npz und data/atlas/ (dichte Wolke); vollständige Provenienz in den Datei-Metas.
Quellen und Referenzen
- SAM3 — Meta AI: github.com/facebookresearch/sam3
- SegDINO — arXiv:2509.00833
- DINOv3 — Meta AI: arXiv:2508.10104
- C-RADIO / AM-RADIO — NVIDIA: arXiv:2312.06709
- SegFormer — arXiv:2105.15203
- DeepLabV3+ — arXiv:1802.02611
- U-Net++ — arXiv:1807.10165
Technische Schlüsselbegriffe
- Semantische SegmentierungZuordnung einer Klasse zu jedem Pixel eines Bildes.
- Foundation ModelAuf sehr grossen Datenmengen vortrainiertes Modell, das ohne oder mit wenig Anpassung auf neue Aufgaben übertragen wird.
- Zero-Shot / Few-ShotAnwendung eines Modells ganz ohne beziehungsweise mit sehr wenigen annotierten Beispielen der Zielaufgabe.
- LoRANachtraining, bei dem nur kleine Zusatzmatrizen lernen, hier 0,55 % der Parameter.
- fg-Makro-mIoUDie Hauptkennzahl des Benchmarks: Überlappungsmass zwischen Modellvorhersage und Referenzannotation, gemittelt nur über die Vordergrundklassen.
- Makro-mIoU (inkl. Hintergrund)Mittelt auch über den Hintergrund und bläht Enthaltung auf rund 0,5 auf; wird nie mit fg-Makro-mIoU vermischt.
- Benchmark / Val. binär / Val. MehrklassenDie drei Auswertungsetiketten des Projekts; jede Zahl trägt eines davon.
- ReferenzannotationVon Menschen erstellte Zielmaske, nie eine Modellausgabe.
- ModellvorhersageVom Modell erzeugte Maske; auf dieser Seite immer als solche beschriftet.
Team
Gregor Hammer, Student
Bachelor of Science FHNW in Data Science & Artificial Intelligence
Christof Weickhardt, Student
Bachelor of Science FHNW in Data Science & Artificial Intelligence
Betreuung
Prof. Dr. Susanne Suter
Dr. Moritz Kirschmann
Institut für Data Science, FHNW
Projektnummer 26FS_I4DS27