
ML-basierte Klassifikation von Posen aus Drucksensordaten
In diesem Projekt wurde untersucht, wie Druckverteilungskarten einer Sensormatte genutzt werden können, um Posen automatisiert zu bestimmen.
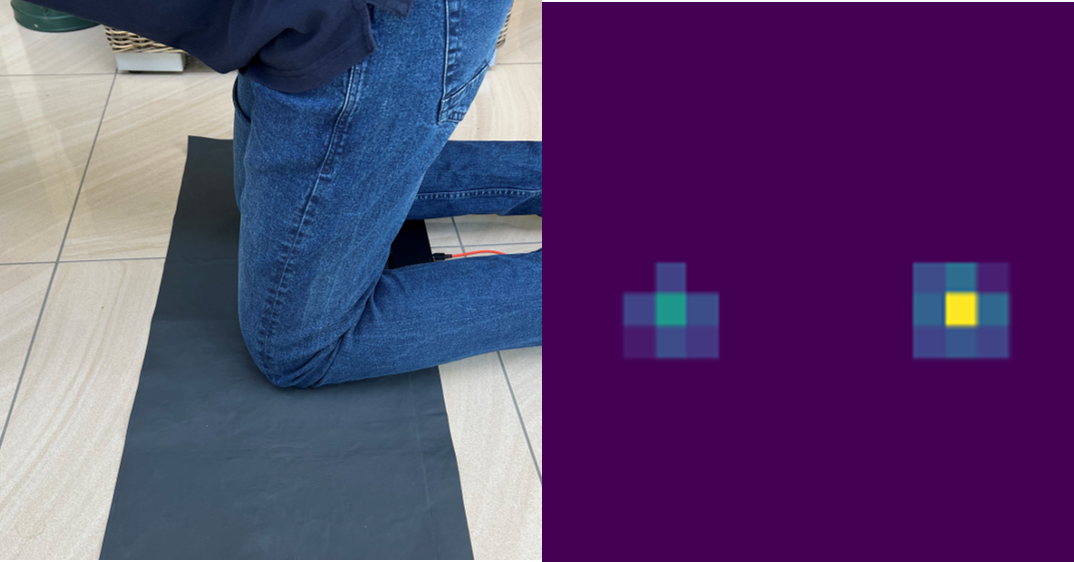
Aufnahme von Druckmustern
Ausgangslage
Sensormatten können kontinuierlich Druckverteilungskarten aufzeichnen. Diese zeigen, wie sich der Druck einer Person auf der Sensormatte verteilt. Aus solchen Daten lassen sich Rückschlüsse auf unterschiedliche Posen ziehen. Die manuelle Auswertung solcher Messdaten ist jedoch aufwendig, besonders wenn über längere Zeiträume viele einzelne Druckkarten entstehen. Deshalb wurde untersucht, ob Machine-Learning-Modelle typische Posen wie Seitenlage, Rückenlage und Kniestand automatisiert erkennen können.
Zielsetzung
Ziel des Projekts war der Aufbau und die Evaluation einer Machine-Learning-Pipeline zur automatisierten Posenbestimmung aus Drucksensordaten. Dafür wurden Druckverteilungskarten eingelesen, aufbereitet, mit Labels verknüpft und mit unterschiedlichen Modellansätzen ausgewertet. Zusätzlich wurde untersucht, welche Modelle sich für eine zuverlässige Klassifikation eignen, wie gut sie auf neue Personen übertragen werden können und ob eine Ausführung auf ressourcenbeschränkter Hardware wie einem Raspberry Pi möglich ist.
Druckverteilungskarten
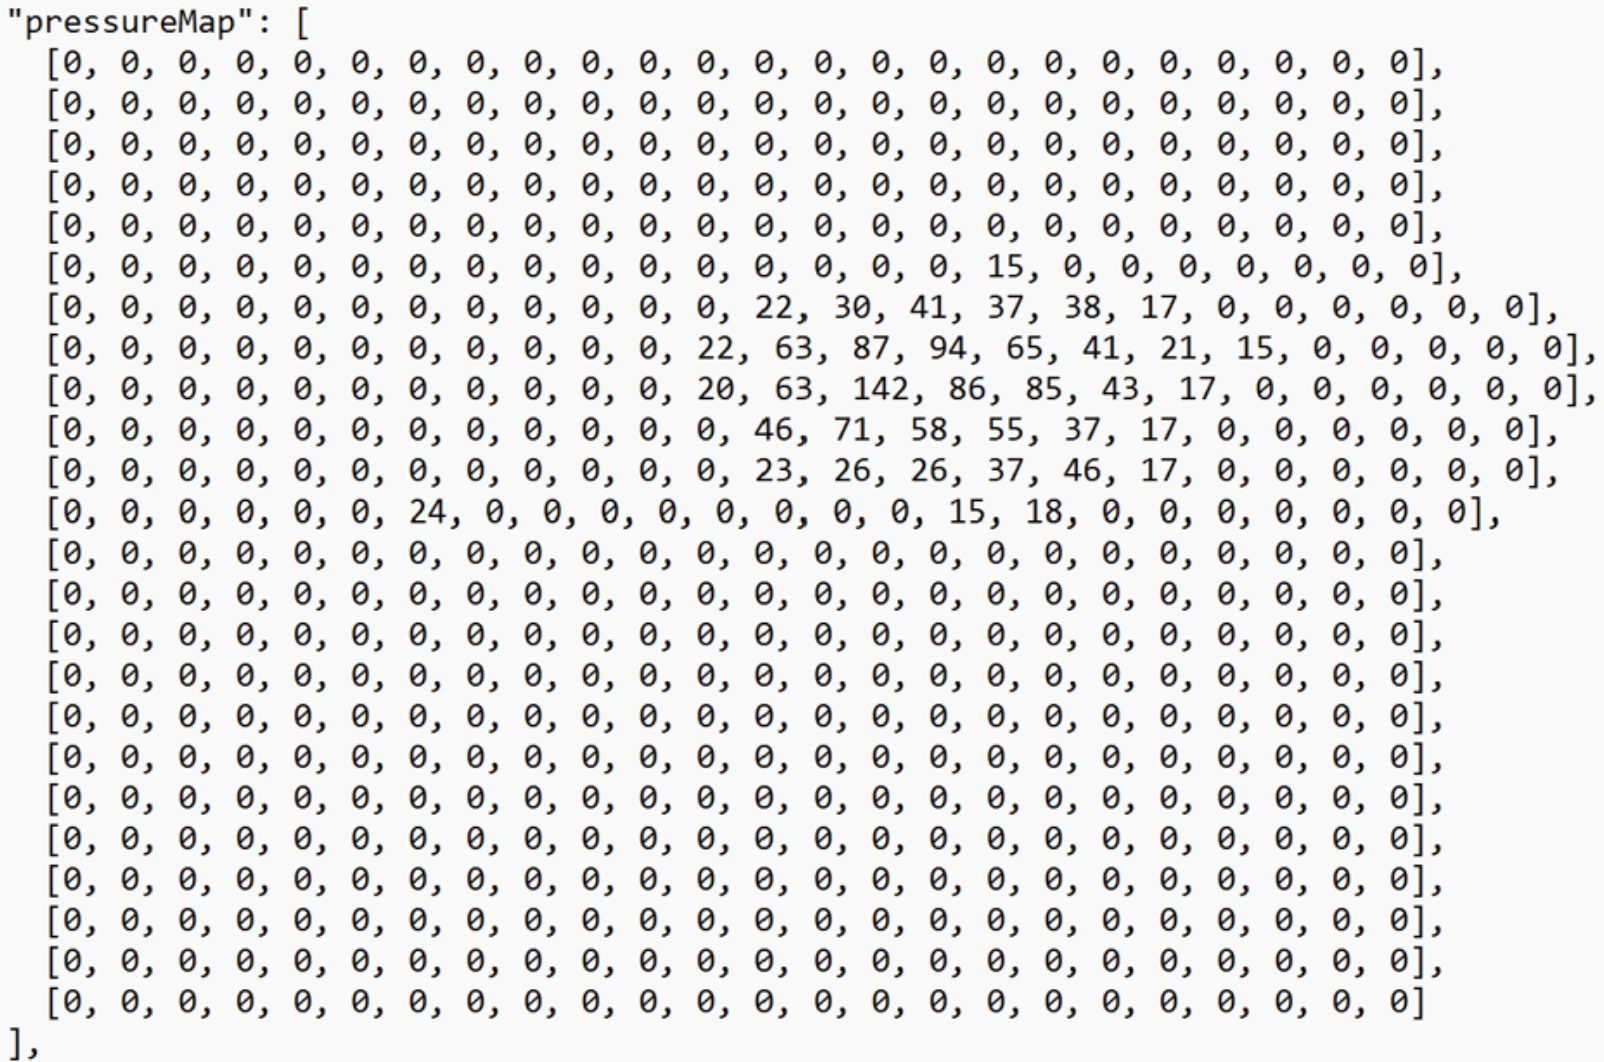
Die Sensormatte erzeugt zweidimensionale Druckverteilungskarten. Je nach Pose entstehen unterschiedliche Muster, Druckzentren und Kontaktflächen.
ML-Pipeline
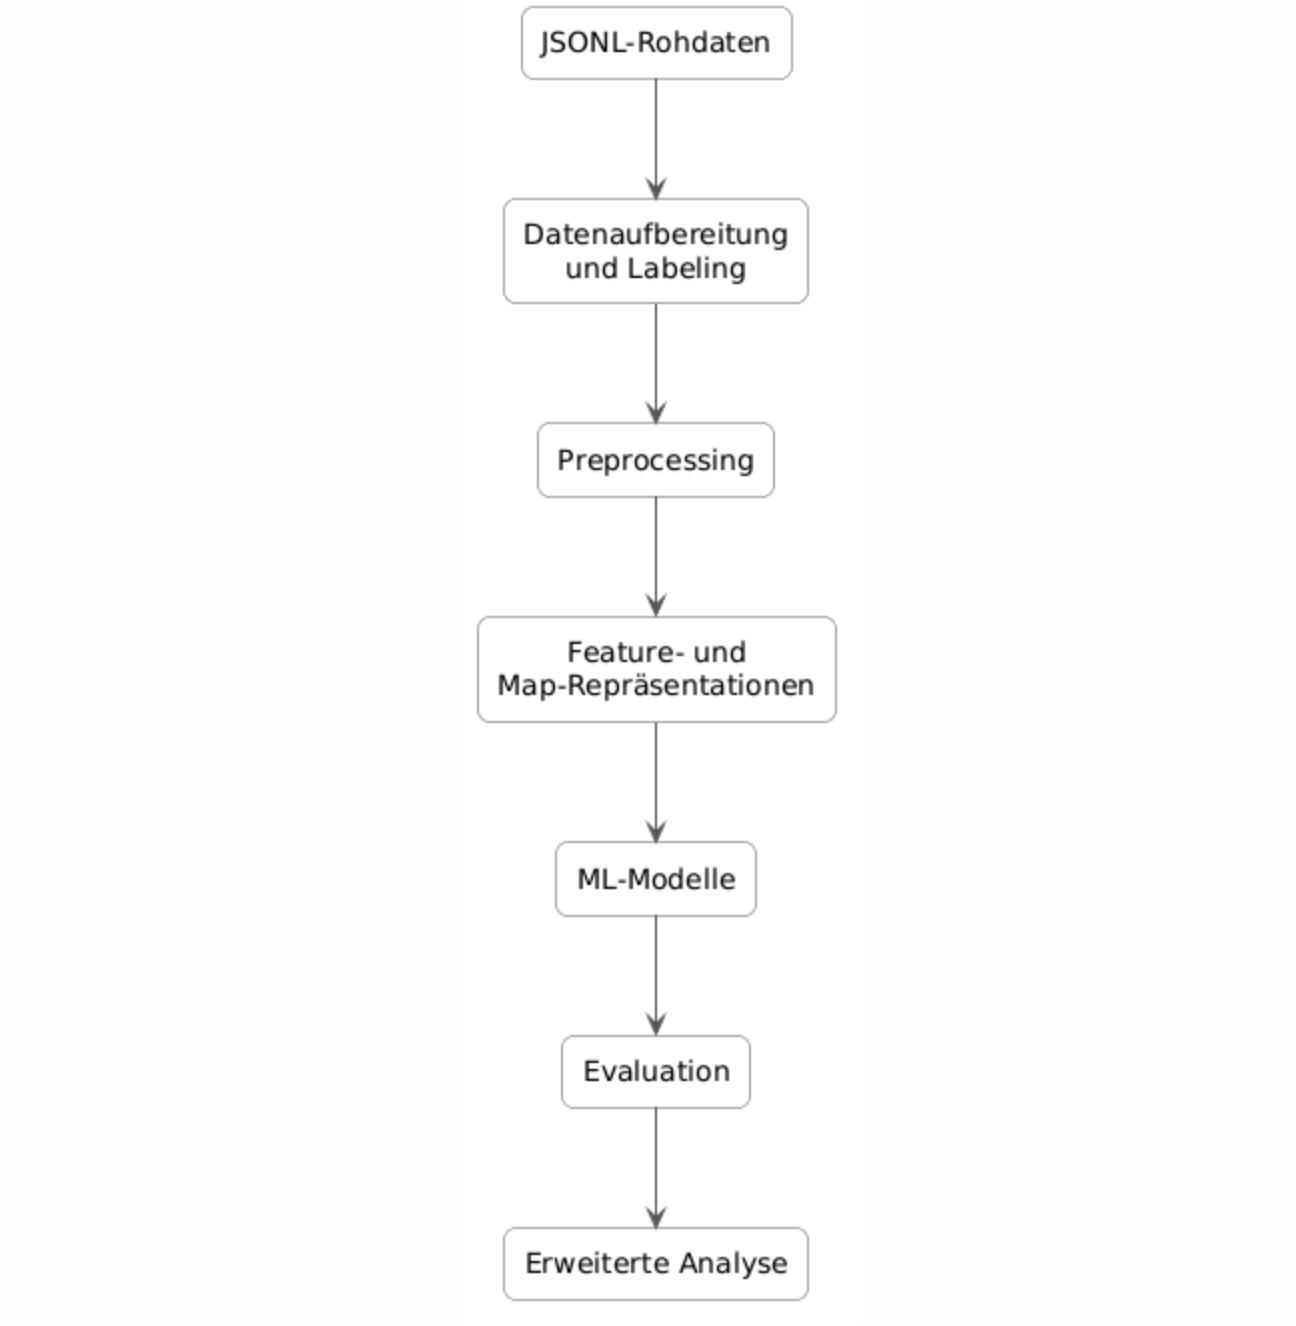
Die Pipeline verarbeitet Rohdaten, ordnet Labels zu, erzeugt Merkmale und bereitet unterschiedliche Eingabeformen für die getesteten Modelle vor.
Modellbewertung
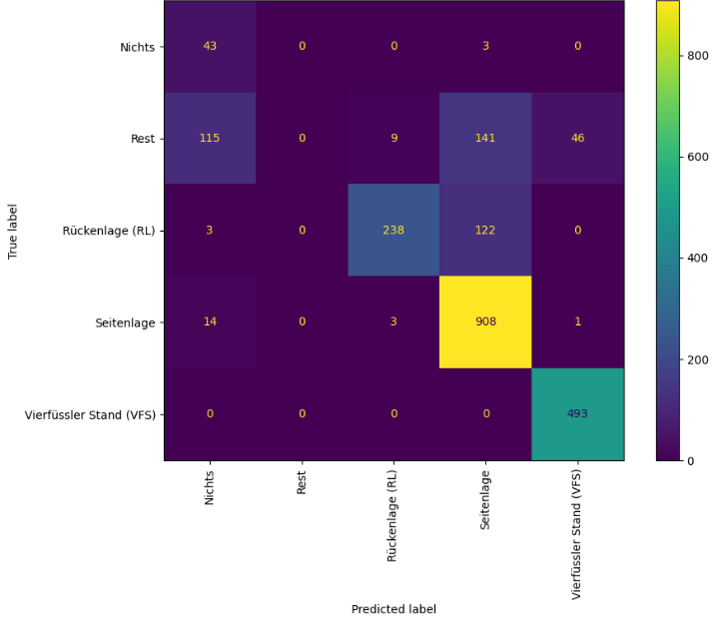
Die Modelle wurden anhand von Accuracy, Macro-F1, Konfusionsmatrizen und zeitlicher Stabilität verglichen. Besonders relevant waren das Random-Forest-Ensemble und das Kalibrierungsmodell.
Ergebnisse
Die Ergebnisse zeigen, dass Druckverteilungskarten grundsätzlich zur automatisierten Posenbestimmung genutzt werden können. Besonders das Random-Forest-Ensemble und das Kalibrierungsmodell erwiesen sich als geeignete Ansätze.
- Aufbau einer vollständigen Pipeline zur Verarbeitung und Klassifikation von Druckverteilungskarten.
- Vergleich verschiedener Modellansätze wie Random Forest, MLP, CNN, CNN-MLP und VAE-MLP.
- Entwicklung eines Random-Forest-Ensembles zur stabilen allgemeinen Posenbestimmung.
- Untersuchung einer personenbasierten Kalibrierung zur Anpassung an neue Personen.
- Evaluation der Modelle mit Accuracy, Macro-F1, Konfusionsmatrizen und zeitlichen Vorhersageverläufen.
- Performanzmessung auf einem Raspberry Pi zur Bewertung der Live-Fähigkeit.
Das Random-Forest-Ensemble eignet sich besonders für eine allgemeine Klassifikation ohne zusätzliche personenbezogene Daten. Das Kalibrierungsmodell zeigte Vorteile, wenn kurze gelabelte Anfangsdaten einer neuen Person verfügbar sind. Die Messungen auf dem Raspberry Pi zeigten zudem, dass eine Live-Auswertung der Drucksensordaten grundsätzlich möglich ist.
Die Arbeit bildet damit eine Grundlage für zukünftige Projekte. Insbesondere können weitere Aufnahmen der Sensormatte gelabelt und für das Training robusterer Modelle zur Posenbestimmung verwendet werden.
Technische Schlüsselbegriffe
- Machine LearningAutomatisierte Klassifikation von Posen anhand von Sensordaten
- DruckverteilungskartenZweidimensionale Darstellung der Druckwerte einer Sensormatte
- Random ForestFeature-basiertes Ensemble-Modell zur Klassifikation
- CNNNeuronales Netz zur Verarbeitung zweidimensionaler Druckkarten
- Feature EngineeringExtraktion numerischer Merkmale aus Druckverteilungskarten
- Personen-KalibrierungAnpassung des Modells an personenspezifische Druckmuster
- Raspberry PiRessourcenbeschränkte Hardware für die Live-Inferenz