
Audio-Based Recognition of States and Activities in Babies
Automatische, lokale und datenschutzfreundliche Erkennung von Babyzuständen aus Smartphone-Audio.
Ausgangslage
In der mobilen Anwendung von baby-sleep-doctors dokumentieren Eltern Schlafen, Wachsein, Weinen und Füttern ihres Kindes. Diese manuelle Protokollierung ist besonders nachts aufwendig und kann zu unvollständigen oder ungenauen Zeitangaben führen.
Smartphone-Audio bietet die Möglichkeit, solche Zustände teilweise automatisch zu erkennen, ohne körpernahe Sensoren einzusetzen. Die Aufgabe ist jedoch anspruchsvoll: Aufnahmen aus realen Haushalten enthalten Sprache, Musik, White Noise, Raumhall und weitere Hintergrundgeräusche. Zudem waren viele öffentlich verfügbare Audiodaten unzuverlässig beschriftet.
Zielsetzung
Die Arbeit untersuchte, ob eine mikrofonbasierte Softwarelösung die Zustände Crying, Awake, Asleep und Feeding aus Smartphone-Aufnahmen zuverlässig klassifizieren kann. Die zusätzliche Klasse Unusable kennzeichnet Aufnahmen, in denen kein Baby eindeutig hörbar ist.
Dafür wurden öffentliche Audiodaten und eigene Aufnahmen aus häuslichen Umgebungen validiert, aufbereitet und zu einem kuratierten Datensatz zusammengeführt. Anschliessend wurden klassische Machine-Learning-Verfahren, neuronale Netze und vortrainierte Audiomodelle verglichen. Neben der Klassifikationsleistung wurden auch Generalisierbarkeit, Modellgrösse und Laufzeit auf einem iPhone untersucht.
Methodischer Workflow
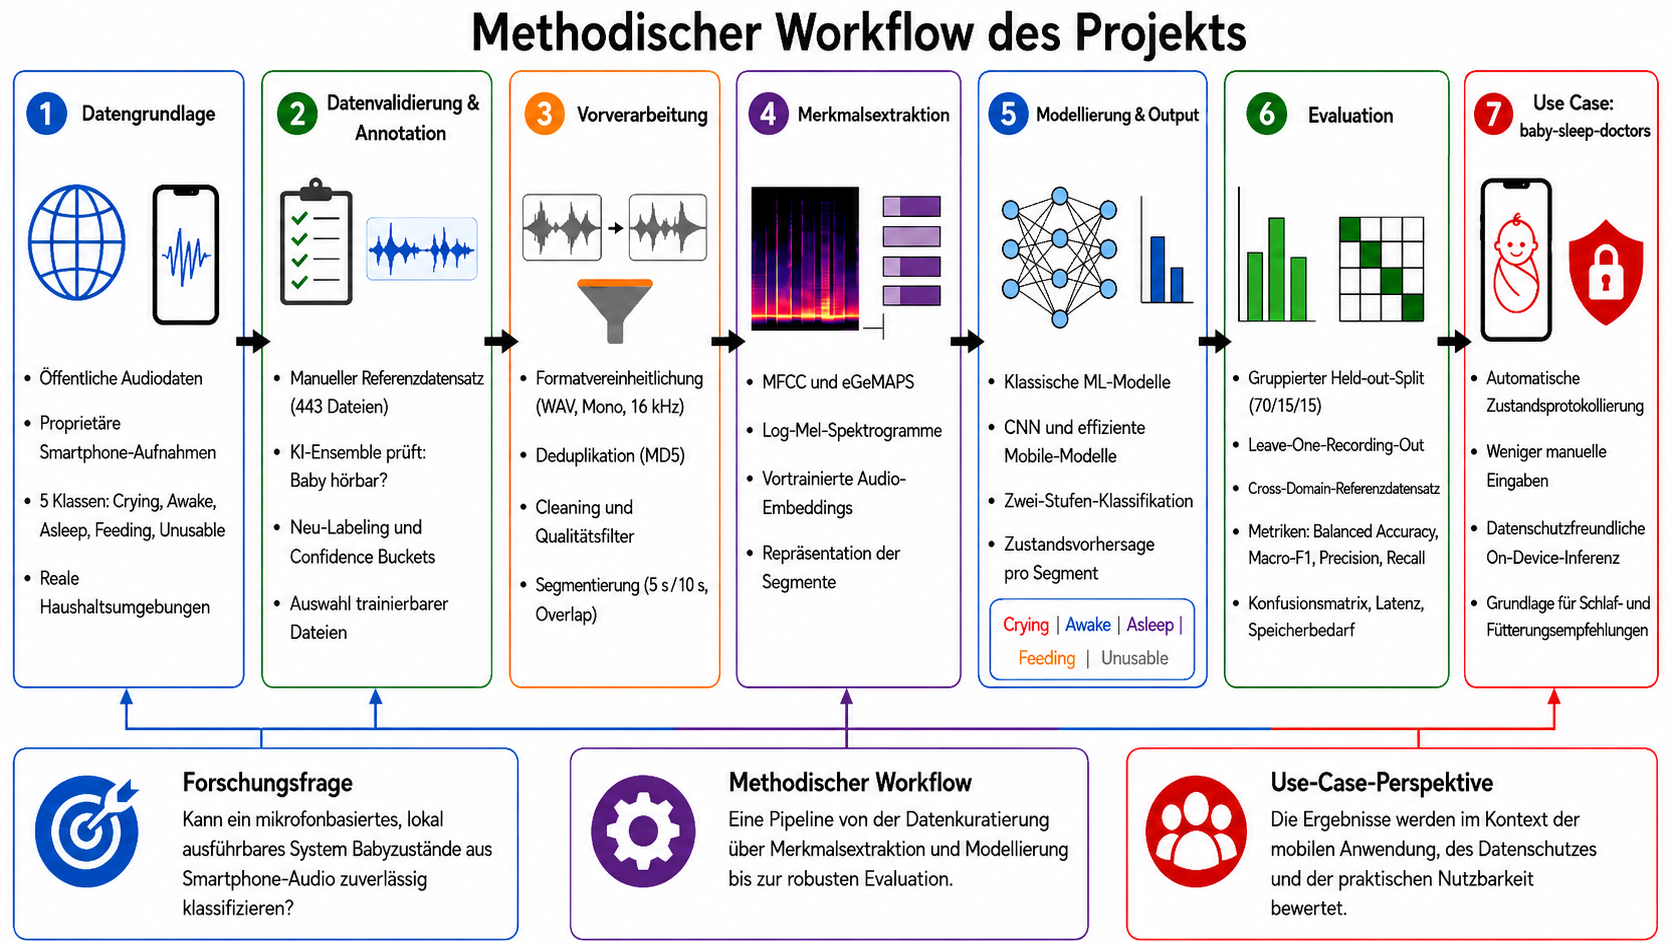
Der Workflow führte von der Datenvalidierung und Vorverarbeitung über die Merkmalsextraktion und den Modellvergleich bis zur robusten Evaluation und zum möglichen Einsatz in der mobilen Anwendung.
Ergebnisse
Aus über 7’000 geprüften Dateien entstand ein kuratierter Datensatz mit 6’553 Fünf-Sekunden-Segmenten. Am zuverlässigsten generalisierten Crying, Awake und Unusable.
- 443 Dateien wurden manuell annotiert.
- Nur 19,6 % der geprüften ursprünglichen Labels waren korrekt.
- BEATs mit optimierter SVM erreichte 0,745 Balanced Accuracy.
- YAMNet bot eine kleinere, ressourcenschonende Alternative.
- YAMNet benötigte rund 2,7 ms pro Fünf-Sekunden-Fenster.
- BEATs benötigte rund 14,4 ms pro Fünf-Sekunden-Fenster.
- Asleep und Feeding benötigen vielfältigere Trainingsdaten.
- Synthetische Daten verbesserten Feeding teilweise.
Die Arbeit liefert damit einen praxistauglichen Klassifikationskern für Crying, Awake und Unusable sowie eine wiederverwendbare Pipeline zur Validierung unzuverlässig beschrifteter Audiodaten.
Die lokale Ausführung auf mobilen Geräten ist technisch praktikabel.
Kernerkenntnis
Eine lokale Audioanalyse auf mobilen Geräten ist technisch möglich. Für die zuverlässige Erkennung aller vier Babyzustände werden jedoch weitere unabhängige Aufnahmen aus unterschiedlichen Haushalten benötigt.
Technische Schlüsselbegriffe
- Audio ClassificationSmartphone-Audio, MFCC, Log-Mel, eGeMAPS
- Machine LearningSVM, CNN, YAMNet, BEATs, CLAP
- EvaluationBalanced Accuracy, Macro-F1, Cross-Domain, Leave-One-Recording-Out
- On-DeviceLokale Inferenz, Datenschutz, Latenz, Modellgrösse
Kund:in
baby-sleep-doctors
baby-sleep-doctor GmbH
Hellweg 3
4314, Zeiningen
Website von baby-sleep-doctors
Team
Arian Iseni
Shane Okomor
Fachbetreuung
Moritz Kirschmann
Susanne Suter