
FinanzBuddy: Wie zuverlässig beantwortet ein KI-Agent Fragen zu Finanzdaten?
Sprachmodelle können Fragen wie «Wie viel habe ich letzten Monat ausgegeben?» in Sekunden beantworten. Ob die Antwort stimmt, ist die eigentliche Frage. Diese Bachelor-Thesis untersucht auf rein synthetischen Daten, wovon die Faktentreue solcher Antworten abhängt, und macht sie messbar.
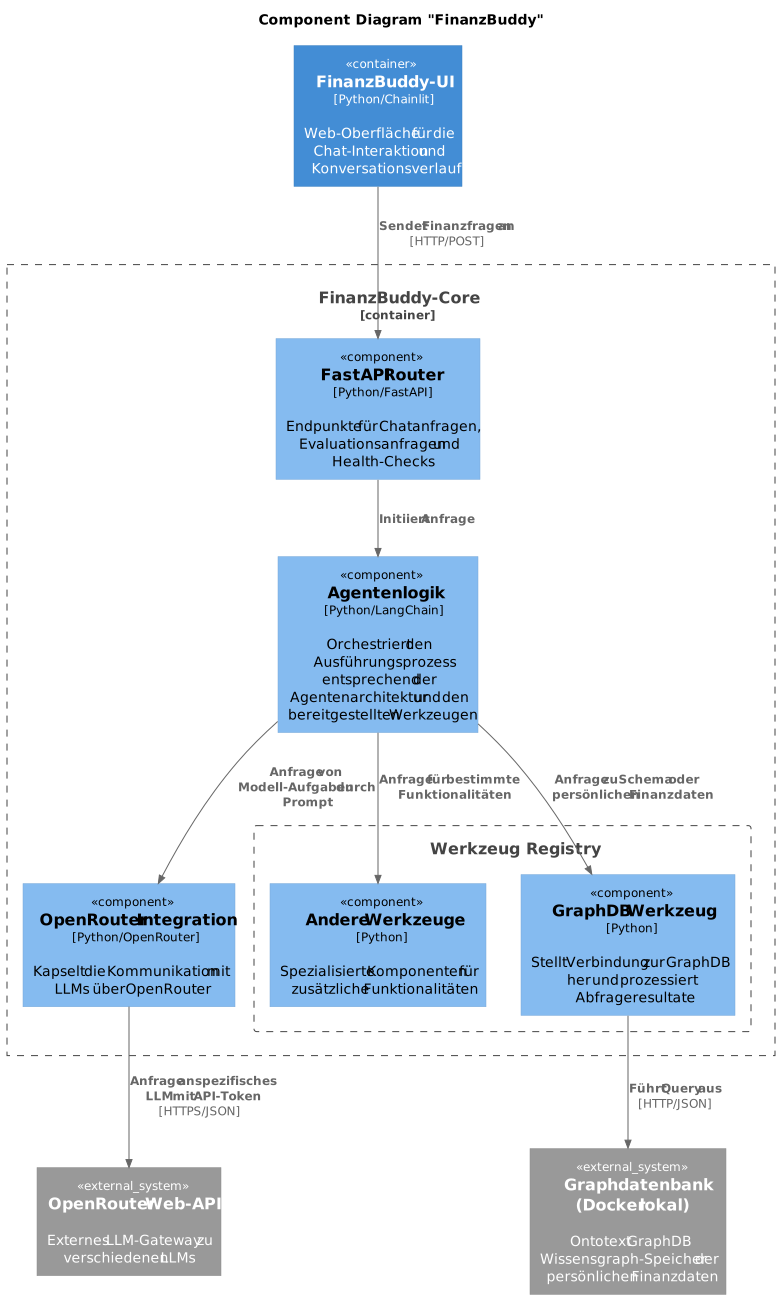
Architektur des Prototyps: Agentenlogik, Werkzeuge und die beiden Datenbanken
Ausgangslage
Conversational Banking beschreibt den natürlichsprachigen Zugang zu den eigenen Finanzdaten. Statt Filter zu setzen und Auswertungen zusammenzuklicken, stellt eine Person eine Frage und erhält eine Antwort. Grosse Sprachmodelle machen diesen Zugang technisch möglich, bringen aber ein Grundproblem mit: Sie formulieren flüssig, auch wenn die Zahlen dahinter falsch sind. Im Bankenumfeld ist eine falsche Aussage über das eigene Konto besonders heikel, weil sie das Vertrauen direkt beschädigt.
Wer ein solches System aufbauen will, stösst schnell auf drei ungeklärte Fragen. Wie müssen Finanzdaten abgelegt und strukturiert sein, damit ein Sprachmodell verlässlich darauf zugreifen kann? Welche Modelle und welche Form der Steuerung eignen sich für Abfragen über strukturierte Daten? Und woran lässt sich überhaupt erkennen, ob eine erzeugte Antwort korrekt ist? Genau dort setzt diese Thesis an. Sie erarbeitet eine technische Entscheidungsgrundlage und keine Produktidee.
Zielsetzung
Die Arbeit verfolgt zwei Ziele. Erstens entsteht ein reproduzierbares Messverfahren, das ein agentisches Finanzanalysesystem strukturiert bewertbar macht. Zweitens wird gemessen, wie stark drei Designentscheide auf die Faktentreue wirken: die Wahl der Datenrepräsentation, die Wahl des Sprachmodells und die Architektur des Agenten.
Der Rahmen ist bewusst eng gesteckt. Sämtliche Finanzdaten sind synthetisch erzeugt, reale Kundendaten kommen zu keinem Zeitpunkt zum Einsatz. Es wird kein Modell trainiert und kein Fine-Tuning durchgeführt. Der Prototyp läuft ausschliesslich lokal, wird nicht in bestehende Systeme integriert und ist kein produktionsreifer Dienst. Was untersucht wird, ist die ingenieurmässige Frage, wie sich vorhandene KI-Fähigkeiten kontrolliert und überprüfbar in ein Softwaresystem einbetten lassen.
Synthetische Daten
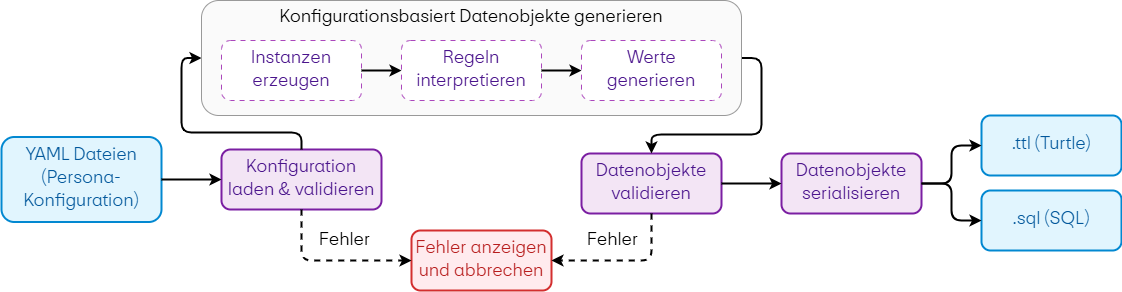
Ein eigener Generator erzeugt aus YAML-Konfigurationen einen vollständigen Finanzdatensatz und schreibt ihn parallel in einen Wissensgraphen und in eine relationale Datenbank. Die Referenzperson umfasst eine Transaktionshistorie über zehn Jahre inklusive Belegen.
Agent im Kontrollzyklus
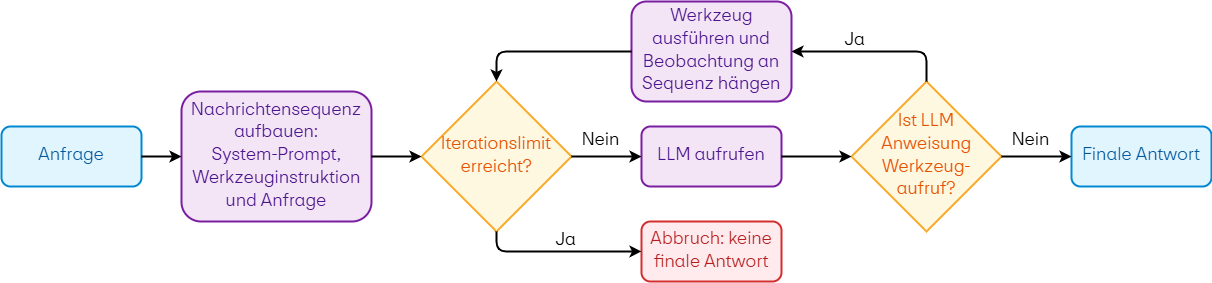
Der Agent zerlegt eine Frage selbstständig, ruft Werkzeuge auf und formuliert daraus Datenbankabfragen. Verglichen werden drei Ausbaustufen: ein einfacher Zyklus, ein Zyklus mit zusätzlicher Selbstprüfung und eine Pipeline aus mehreren spezialisierten Agenten.
Messbare Faktentreue
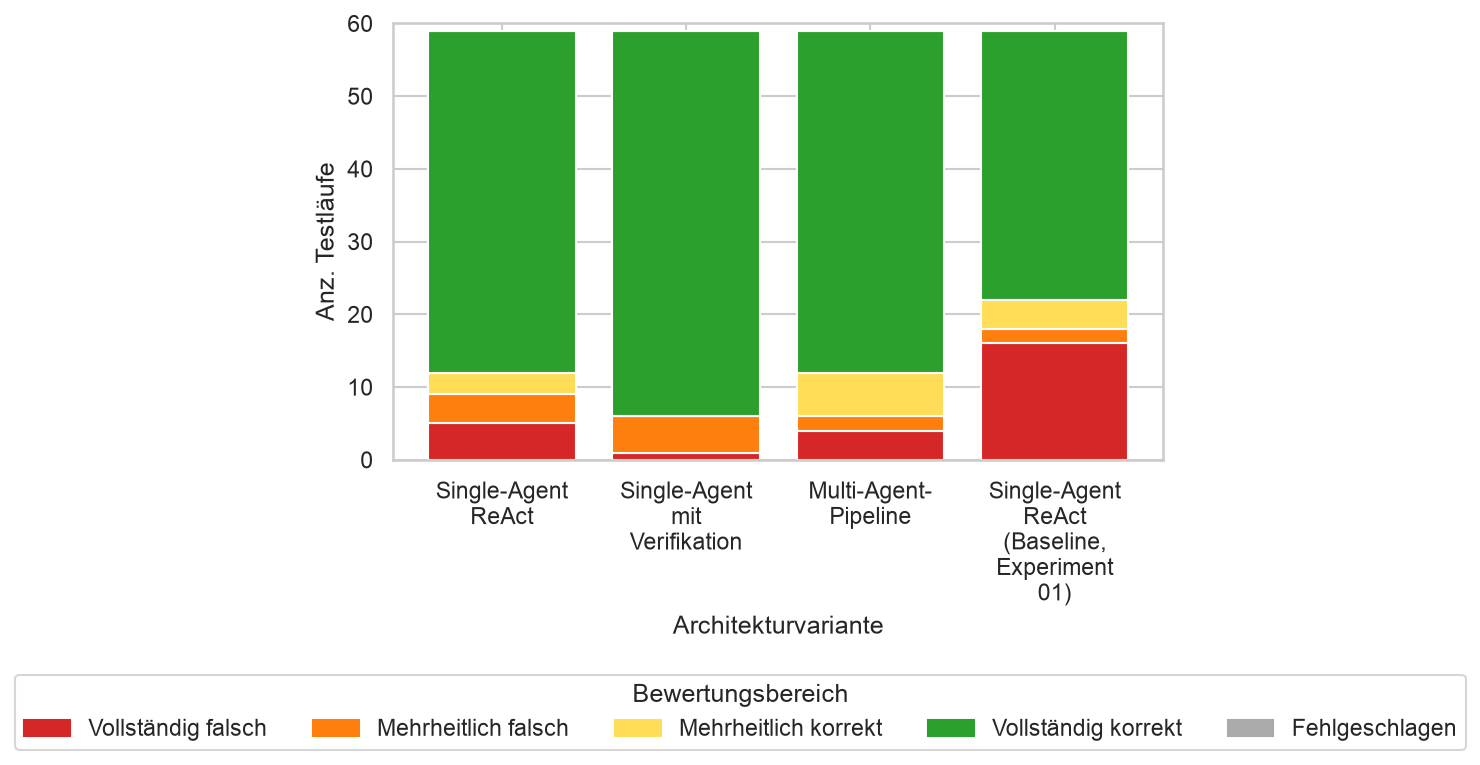
Ein Katalog aus 59 Testfällen prüft jede Systemvariante unter identischen Bedingungen. Ein zweites Sprachmodell bewertet jede Antwort gegen eine vorab bestimmte Referenz und vergibt einen Score zwischen 0 und 1.
Ergebnisse
Entstanden sind zwei Artefakte. Der Prototyp «FinanzBuddy» ist eine Python-Anwendung, die einen Agenten über LangChain steuert, ihm fünf Werkzeuge zur Verfügung stellt und die Sprachmodelle über eine austauschbare Schnittstelle anbindet. Daneben steht die Evaluationspipeline, die jede Systemvariante automatisiert gegen denselben Fragenkatalog laufen lässt. Im ersten Experiment wurden so 16 Konfigurationen und 944 Testläufe ausgewertet.
Die Messungen widerlegen zwei verbreitete Annahmen und bestätigen eine dritte:
- Die Datenrepräsentation entscheidet nicht über die Genauigkeit. Wissensgraph und relationale Datenbank liefern vergleichbare Ergebnisse, der Graph benötigt dafür deutlich mehr Tokens und mehr Zeit.
- Das Modell ist der stärkste einzelne Hebel. GPT 5.5 erreicht im Mittel einen Score von 0,777, Claude Opus 4.8 folgt mit 0,744. Die Open-Weight-Modelle Qwen 3.6-27B und Kimi K2.7 liegen dahinter.
- Reasoning wirkt nicht bei jedem Modell gleich. Ohne Reasoning verliert GPT 5.5 im Schnitt 0,248 Punkte, Claude Opus 4.8 lediglich 0,021.
- Präzisere Anweisungen im System-Prompt heben denselben Aufbau von 0,686 auf 0,852.
- Ein zusätzlicher Verifikationsschritt bringt den höchsten gemessenen Wert von 0,925, verdoppelt aber den Tokenverbrauch. Die Multi-Agent-Pipeline liegt mit 0,878 dazwischen und spielt ihre Stärke erst bei Fragen aus, die mehrere Abfragen verbinden.
- Die verbleibenden Fehler entstehen fast nie beim Rechnen, sondern beim Übersetzen. Fehlt einem alltagssprachlichen Begriff eine eindeutige Entsprechung im Datenmodell, trifft der Agent eine Annahme und weist sie nicht aus.
Für die Praxis heisst das: Aufwand lohnt sich dort, wo Fachbegriffe sauber definiert und dem Modell erklärt werden, und nicht zwingend beim Umbau der Datenhaltung. Die Arbeit zeigt zugleich, wie empfindlich eine solche Messung auf die Datenbasis reagiert. Ein einzelner Eingriff, der nicht über alle Varianten nachgezogen wird, verzerrt sämtliche Läufe. Eine fixierte und versionierte Datenbasis ist damit Voraussetzung jeder belastbaren Aussage.
Alle Ergebnisse beziehen sich auf synthetische Daten und auf isolierte Einzelfragen. Sie sind als technische Entscheidungsgrundlage zu lesen und nicht als Aussage über ein bestehendes oder geplantes Produkt. Der nächste Schritt wäre eine Wiederholung der Messungen auf einem realen, anonymisierten Datensatz sowie eine Bewertung, die auch Rückfragen und mehrschrittige Gespräche erfasst.
Technische Schlüsselbegriffe
- LLM-AgentSprachmodell, das über einen Kontrollzyklus eigenständig Werkzeuge auswählt und aufruft
- ReActMuster aus abwechselndem Überlegen und Handeln, hier als Single-Agent- und als Multi-Agent-Variante umgesetzt
- FaktentreueEine Antwort enthält ausschliesslich Angaben, die aus den vorliegenden Daten ableitbar sind
- HalluzinationVom Modell erzeugte Information ohne Beleg in den Eingabedaten
- LLM-as-a-JudgeAutomatisierte Bewertung einer Antwort durch ein zweites Sprachmodell gegen eine Referenz
- WissensgraphRDF-Daten in einem Triplestore, abgefragt über SPARQL
- Text-to-SQLÜbersetzung einer natürlichsprachigen Frage in eine Datenbankabfrage
- Synthetische DatenVollsynthetisch generierter Finanzdatensatz ohne Rückschluss auf reale Personen
- TechnologienPython, FastAPI, LangChain, GraphDB, PostgreSQL, Chainlit, Docker
Kund:in
PostFinance AG
Mingerstrasse 20
3030 Bern
postfinance.ch
Team
Zacharia Ghammar
Noah Schär
Betreuung
Prof. Dr. Daniel Perruchoud
Jonas Grüter