
Entwicklung von smarten Auto-Completion-Modellen mit niedriger Latenz
Das Projekt untersucht, wie strukturierte Eventattribute automatisch aus bestehenden Eventtexten vorgeschlagen oder extrahiert werden können. Ziel ist ein latenzarmes System, das Veranstaltende bei der Erfassung von Events unterstützt und redundante manuelle Eingaben reduziert.
Ausgangslage
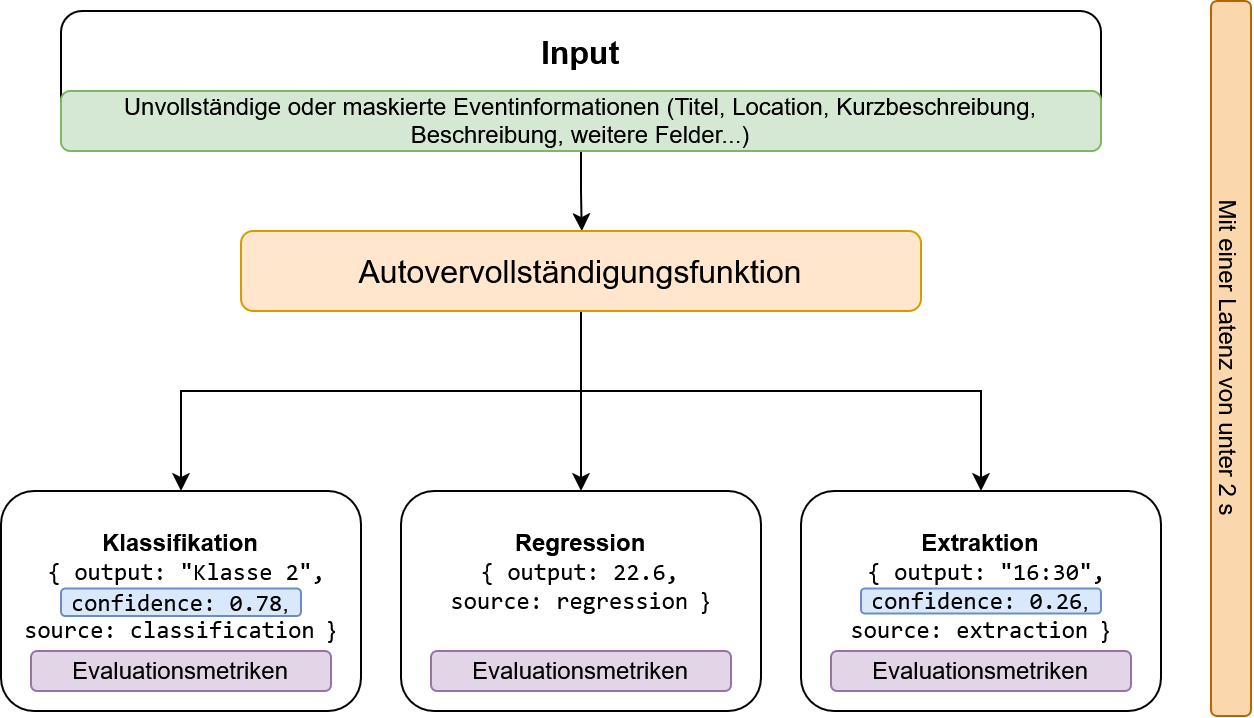
Bei der Erfassung von Events müssen Veranstaltende viele Informationen manuell eingeben. Einige dieser Informationen sind bereits im Titel, in der Kurzbeschreibung oder in der Eventbeschreibung enthalten. Andere Angaben lassen sich zumindest teilweise aus dem Kontext ableiten. Dazu gehören beispielsweise Zielgruppen, Altersangaben, Zeitinformationen oder weitere Eventattribute.
Das manuelle Erfassen solcher Informationen ist zeitaufwändig und fehleranfällig. Eine automatische Ergänzung strukturierter Eventattribute kann helfen, redundante Eingaben zu reduzieren und die Datenqualität zu verbessern. Gleichzeitig stellt die Aufgabe hohe Anforderungen: Die Vorhersagen müssen schnell genug für einen interaktiven Erfassungsprozess sein und ihre Konfidenzwerte sollten interpretierbar sein.
Zielsetzung
Ziel der Arbeit war die Entwicklung und Evaluation von Verfahren zur automatischen Ergänzung strukturierter Eventdaten. Dazu wurden unterschiedliche Aufgabentypen betrachtet: Klassifikationsaufgaben für binäre Attribute, Regressionsaufgaben für numerische Werte und Extraktionsaufgaben für direkt im Text erwähnte Informationen.
Zusätzlich wurde untersucht, wie sich unterschiedliche Modellgrössen und Architekturen auf Vorhersagequalität und Inferenzlatenz auswirken. Ein weiterer Fokus lag auf der Frage, wie verlässlich die ausgegebenen Konfidenzwerte sind und ob sie als Grundlage für automatische Vorschläge oder Fallback-Entscheidungen genutzt werden können.
Eventtext zu Attributen
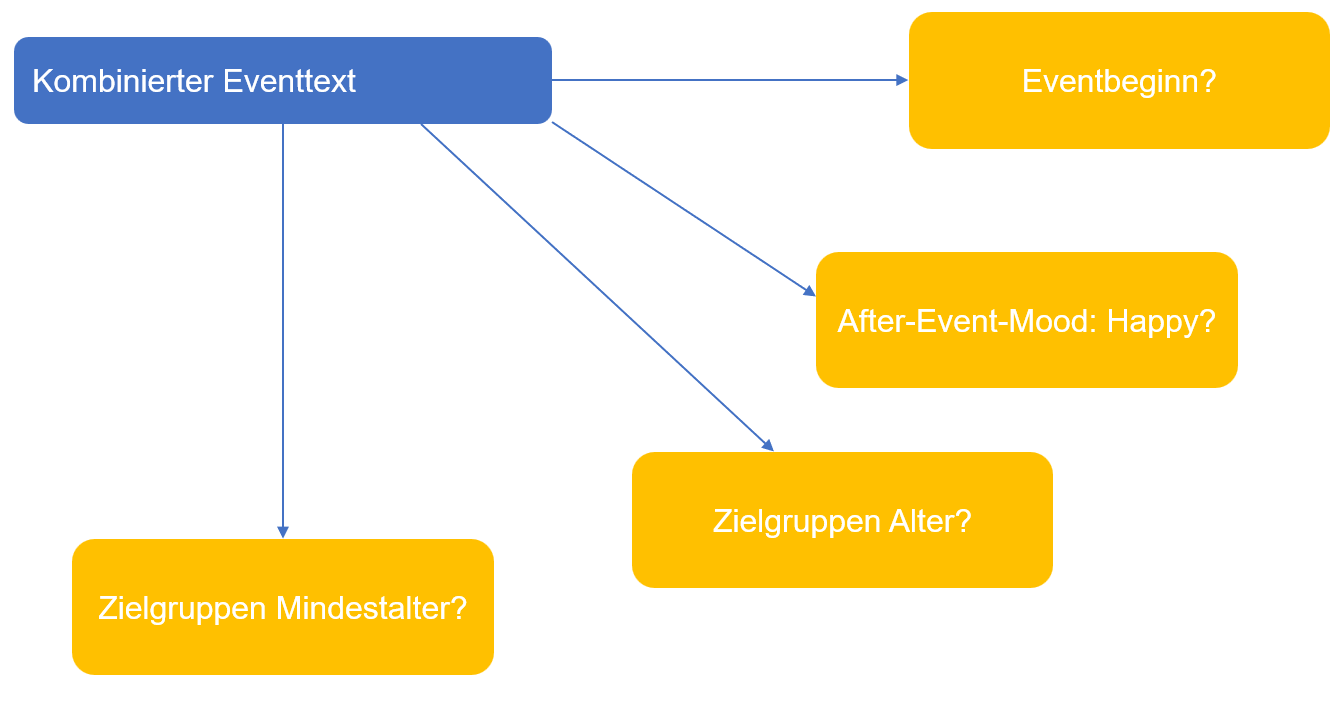
Als Eingabe dienen Eventtitel, Kurzbeschreibung und Beschreibungstext. Daraus werden strukturierte Attribute vorgeschlagen, beispielsweise der Eventbeginn, mögliche Zielgruppen, Altersangaben oder erwartete After-Event-Moods wie Glücklichsein nach dem Event.
Qualität und Latenz
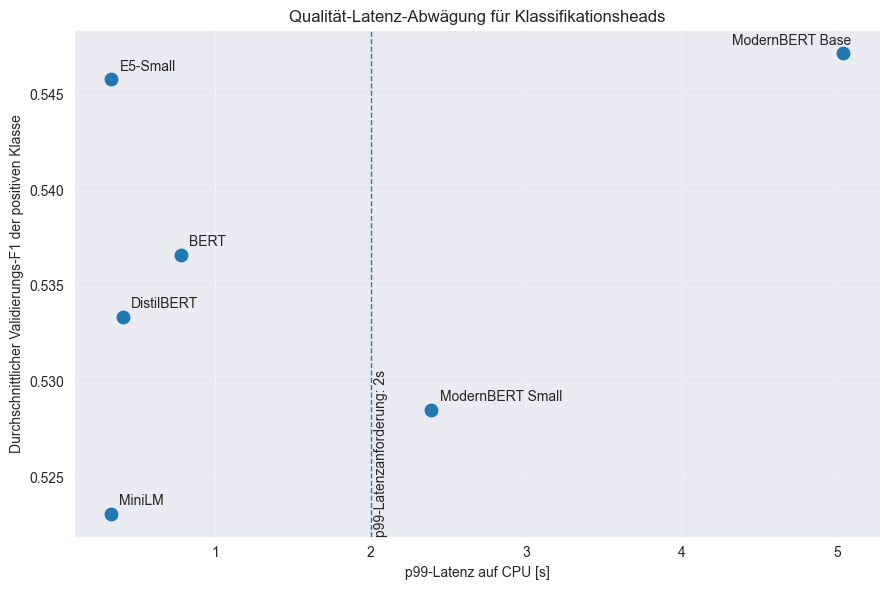
Die Modelle wurden hinsichtlich Vorhersagequalität und Antwortzeit verglichen. DistilBERT erwies sich dabei als guter Kompromiss: 99 Prozent der gemessenen Anfragen wurden auf CPU in weniger als 0.41 Sekunden verarbeitet und damit deutlich innerhalb der vorgegebenen zwei Sekunden. Die dargestellte Qualitätsskala ist vergrössert, um die vergleichsweise kleinen Unterschiede zwischen den Modellen sichtbar zu machen.
Kalibrierung der Konfidenzen
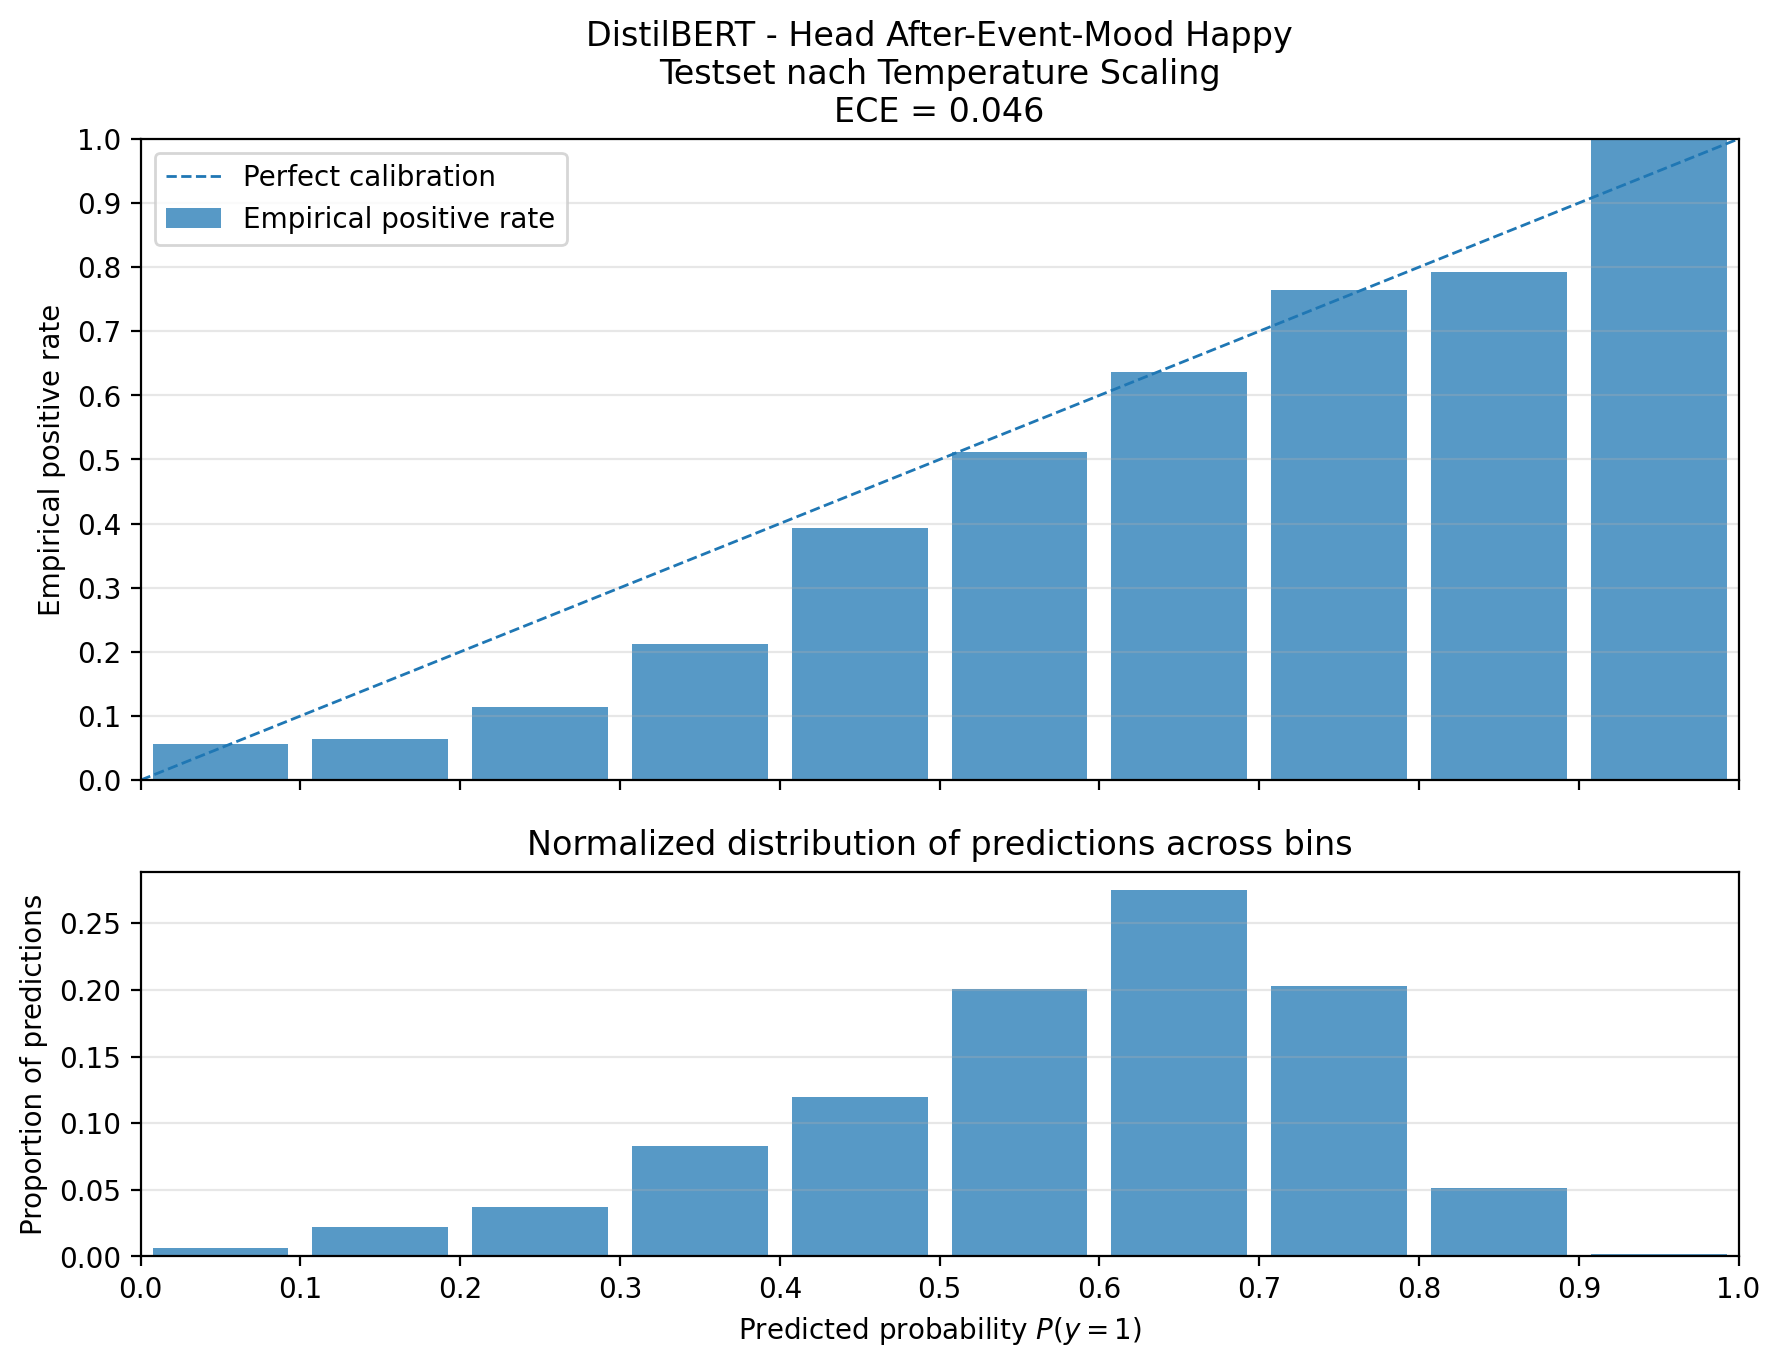
Reliability Diagrams zeigen, wie gut die vom Modell ausgegebenen Konfidenzen mit den tatsächlich beobachteten Trefferhäufigkeiten übereinstimmen. Je näher die Werte an der Diagonalen liegen, desto besser ist das Modell kalibriert. Die ergänzende Bin-Verteilung zeigt, wie viele Vorhersagen in den jeweiligen Konfidenzbereichen liegen. Die Kalibrierung konnte die Übereinstimmung verbessern, sehr hohe Konfidenzwerte blieben jedoch teilweise zu optimistisch. Die Ergebnisse können später als Grundlage für Schwellenwerte oder Fallback-Entscheidungen dienen.
Vorgehen
Im Projekt wurden vorhandene Eventdaten analysiert und in Trainings-, Validierungs- und Testdaten aufgeteilt. Die Modelle nutzten primär Titel, Kurzbeschreibung und Beschreibungstext als Eingabe. Darauf aufbauend wurden eine LLM-basierte Baseline sowie mehrere transformerbasierte Backbone-Modelle untersucht.
Die trainierten Modelle wurden mit task-spezifischen Ausgabeköpfen für Klassifikation, Regression und Extraktion kombiniert. Da für die Textpositionen der Zeitangaben keine manuellen Annotationen vorlagen, wurden diese als sogenannte Silver Labels mit einem Sprachmodell erzeugt und vor der Verwendung automatisch verifiziert. Für die Evaluation wurden je nach Aufgabentyp unterschiedliche Metriken eingesetzt. Zusätzlich wurden Latenzmessungen und Kalibrierungsanalysen durchgeführt.
Ergebnisse
Die Resultate zeigen, dass die automatische Ergänzung strukturierter Eventattribute grundsätzlich realistisch ist. Die Eignung hängt jedoch stark vom jeweiligen Attribut ab. Direkt im Text enthaltene oder fachlich klar definierte Informationen lassen sich besser modellieren als seltene, subjektive oder nur indirekt ableitbare Zielvariablen.
- Transformerbasierte Modelle können verschiedene strukturierte Eventattribute aus vorhandenen Textinformationen vorhersagen oder extrahieren.
- Die LLM-Baseline erkannte bei Zeitfeldern zuverlässig, ob eine Angabe vorhanden war, und lieferte bei numerischen Aufgaben gute Resultate. Aufgrund hoher Latenz und laufender Kosten eignet sie sich jedoch eher als Referenz und zur Erzeugung von Silver Labels als für den direkten produktiven Einsatz.
- DistilBERT erwies sich im untersuchten Setup als guter Kompromiss zwischen Vorhersagequalität und Inferenzlatenz.
- Stark unausgeglichene oder interpretative Attribute bleiben schwierig vorherzusagen.
- Das gemeinsame Fine-Tuning des Backbones konnte einzelne Modellleistungen verbessern, zeigte jedoch auch eine erhöhte Anfälligkeit für Overfitting.
- Temperature Scaling verbesserte die Kalibrierung der maximal vorhergesagten Klassenwahrscheinlichkeit, während hohe positive Konfidenzen weiterhin teilweise überkonfident blieben.
- Die Robustheitsanalyse zeigte, dass einzelne fehlende Eingabefelder gut verkraftet werden, das Fehlen des Beschreibungstextes jedoch zu deutlichen Einbussen führt: Zielgruppenbezogene Attribute blieben stabil, während stimmungsbezogene, numerische und zeitliche Attribute auf den Beschreibungstext angewiesen sind.
- Für einen produktiven Einsatz sind task-spezifische Schwellenwerte, Fallback-Strategien und weitere Robustheitsanalysen erforderlich.
Insgesamt zeigt die Arbeit, dass ein latenzarmer Multi-Head-Ansatz auf Basis eines effizienten Sprachmodells ein sinnvoller Ausgangspunkt für eine Auto-Completion-Funktion im Event-Erfassungsprozess ist. Gleichzeitig müssen automatische Vorschläge abhängig von Zielattribut, Konfidenz und erwarteter Fehlerwirkung unterschiedlich behandelt werden.
Fazit
Automatische Attributvorschläge aus Eventtexten sind technisch realistisch, benötigen für den produktiven Einsatz jedoch eine sorgfältige Kombination aus Modellqualität, Latenzanforderungen, Kalibrierung und Fallback-Strategien.
Technische Schlüsselbegriffe
- Natural Language ProcessingAutomatische Verarbeitung und Analyse natürlicher Sprache.
- TransformerModellarchitektur zur Verarbeitung von Textsequenzen mit Self-Attention.
- DistilBERTKompaktes transformerbasiertes Sprachmodell mit gutem Verhältnis zwischen Qualität und Latenz.
- Large Language ModelsGrosse Sprachmodelle, die als Baseline für Extraktion und Vorhersage strukturierter Attribute sowie zur Erzeugung von Silver Labels verwendet wurden.
- Information ExtractionExtraktion explizit erwähnter Informationen aus Freitexten.
- Text ClassificationVorhersage binärer Eventattribute auf Basis vorhandener Texte.
- Multi-Head-ArchitekturGemeinsames Backbone-Modell mit mehreren task-spezifischen Ausgabeköpfen, sodass die Texteingabe nur einmal verarbeitet werden muss.
- Silver LabelsAutomatisch durch ein Sprachmodell erzeugte und verifizierte Trainingsannotationen, hier für die Textpositionen der Zeitangaben.
- Model CalibrationAnalyse und Verbesserung der Verlässlichkeit von Modellkonfidenzen.
Kund:in
Eventfrog AG
Eventfrog ist eine Schweizer Plattform zur Veröffentlichung von Veranstaltungen und zum Verkauf von Tickets.
Website von Eventfrog
Team
Aaron Studer
Damian Sägesser
Betreuung
Daniel Perruchoud
Stephan Heule
Industriebetreuung
Yanick Zengaffinen, Eventfrog