
Image Processing for Rail Grinding Machine
Diese Arbeit untersucht die zuverlässige Erkennung der beiden Aussenkanten einer Schiene auf Kamerabildern aus der Draufsicht. Verglichen werden drei sehr unterschiedliche Ansätze: klassische Kantenerkennung, semantische Segmentierung und ein transformer-basiertes Linien-Detektionsmodell, welche auf denselben Daten trainiert und auf denselben Testbildern bewertet wurden.
Ausgangslage
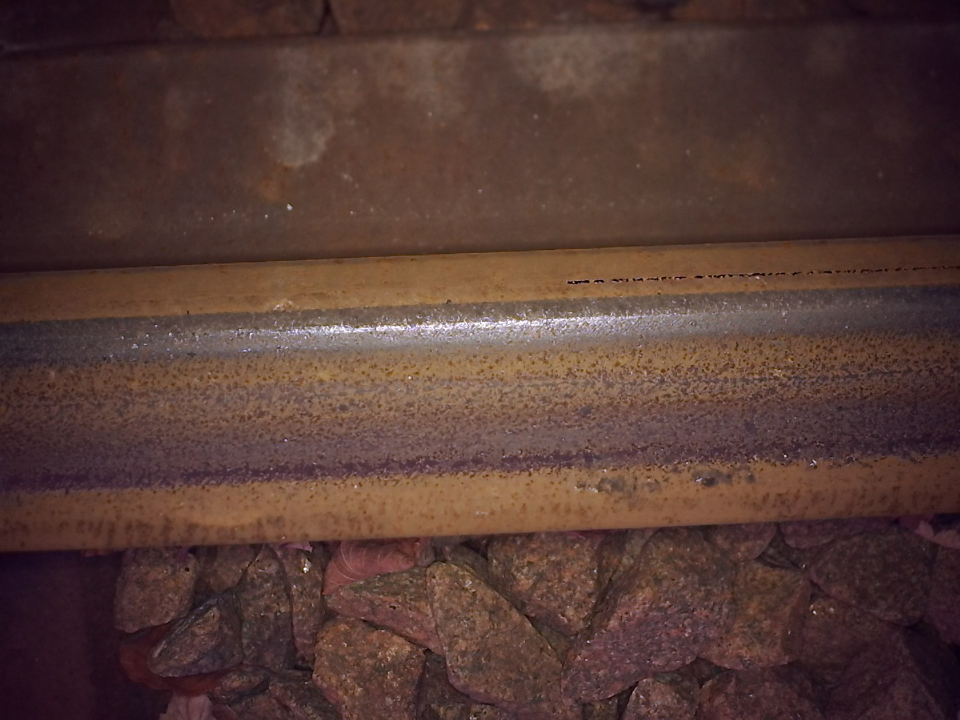
Schienen werden aktuell vor allem aus der Führerhausperspektive erkannt. Dies ist nützlich um im normalen Bahnverkehr Weichen und Kurven zu erkennen. Auch von der Draufsicht werden Bilder von Schienen aufgenommen und verarbeitet. In der aktuellen Forschung wird der Hauptfokus dabei vor allem auf die Detektion von einzelnen Schienenelementen wie Schrauben gelegt oder es geht um eine Detektion von Anomalien. In dieser Thesis sollen die Schienen selbst beziehungsweise ihre Aussenkanten zuverlässig erkannt werden.
Zielsetzung
Die Erkennung der Aussenkanten von Schienen kann für gewisse Prozesse eine Grundlage sein für eine spätere Automatisierung mithilfe von Bilddaten. Die Thesis soll die Machbarkeit einer solchen Erkennung testen und deren Limitationen aufzeigen.
Detektierte Schienenkanten
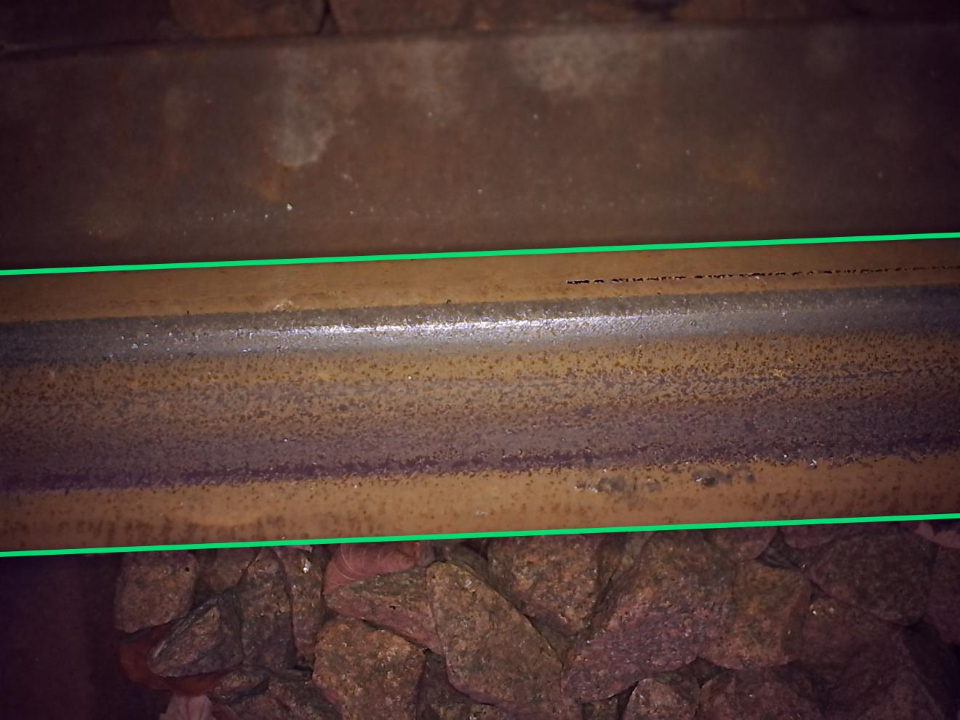
Vorhersage der beiden Aussenkanten durch das LINEA-Modell direkt auf dem Kamerabild.
Abgeleitete Fläche
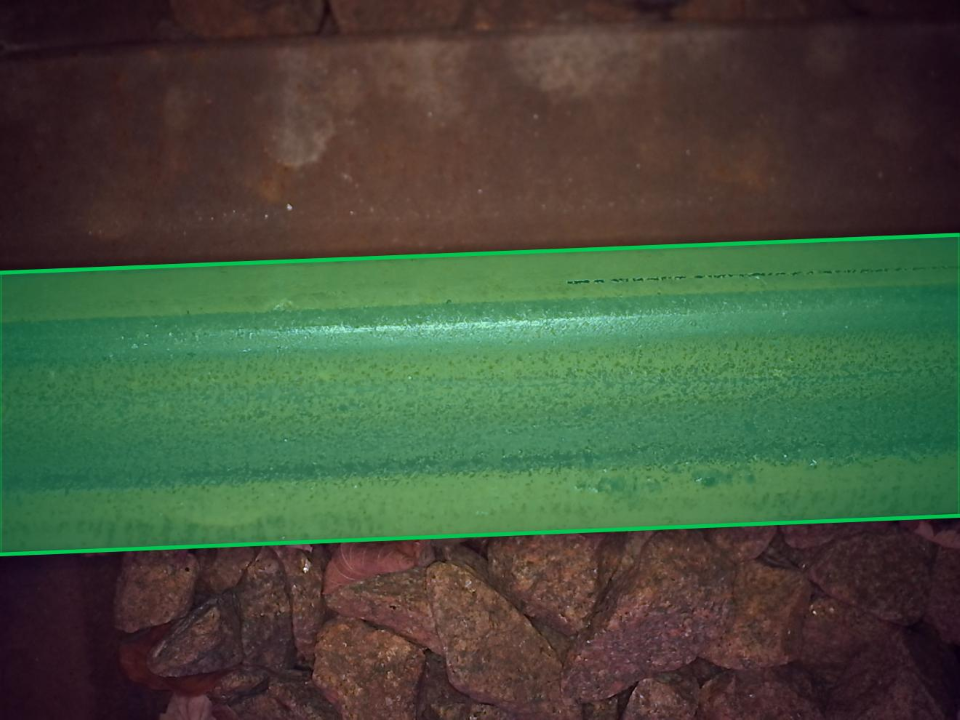
Aus den zwei detektierten Kanten wird eine Fläche gebildet, welche für den Vergleich der Verfahren mit einer pixelweisen Metrik dient.
Vergleich der Ansätze
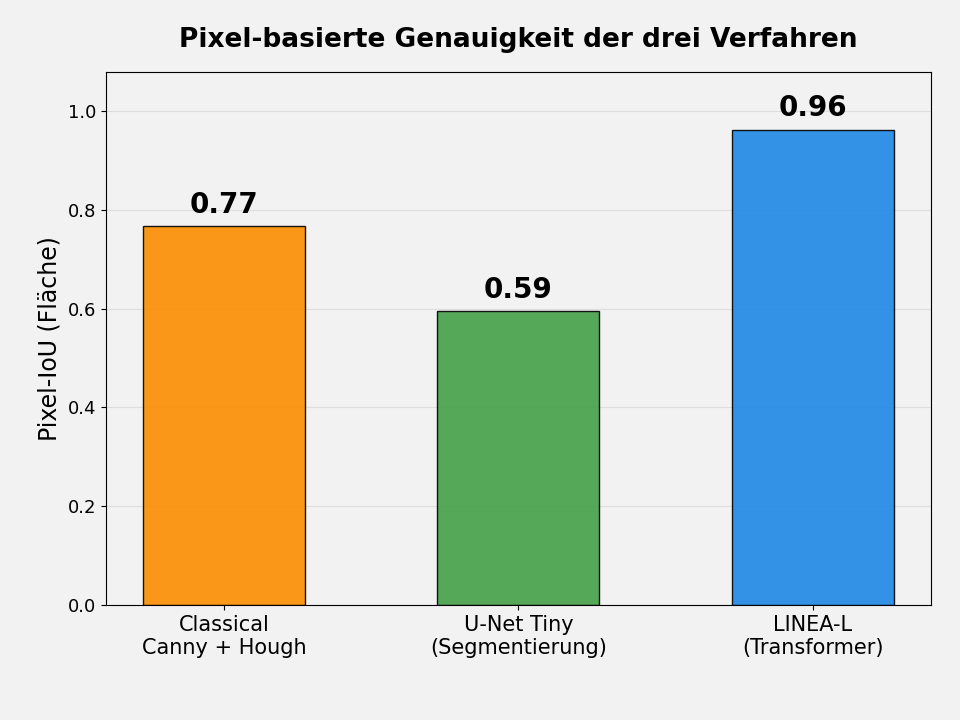
Pixel-basierte Genauigkeit der drei Ansätze. Das LINEA-Modell erreicht deutlich höhere Werte als die beiden Baselines.
Ergebnisse
Um die Kanten zu erkennen, wurden drei Ansätze angewendet:
- Klassische Kantenerkennung (Canny + Hough)
- U-Net (semantische Segmentierung)
- LINEA (Transformer-basierte Linien-Detektion)
In der klassischen Kantenerkennung wurde versucht, die Kanten ohne Labels oder sonstige Vorinformation zu erkennen. Dazu wurde eine Canny Edge Detection durchgeführt, welcher danach eine Hough-Transformation folgte, um Linien auf den Bildern zu extrahieren. Dabei stellte sich heraus, dass diese Methode zwar auf immer gleichen Bildern gut funktioniert, jedoch bei Bildern mit mehr Noise, wie einem etwas chaotischeren Schienenbett, Mühe hat, die Linien richtig zu erkennen.
Mit dem U-Net wurde versucht, jeden Pixel der Schienenoberfläche zu klassifizieren (Semantic Segmentation) und so die Fläche der Schiene als Maske vorherzusagen. Das Modell konnte den inneren Teil der Schiene grob gut erkennen, hatte jedoch Mühe, die genauen Kanten sauber abzugrenzen.
Letztlich wurde ein LINEA-Modell trainiert. LINEA ist ein transformer-basiertes Modell, welches ursprünglich für die Erkennung von Linien in Innenraum-Architekturaufnahmen konzipiert wurde. Das Modell wurde so angepasst und die Optimierungsmetriken so verändert, dass es die Schienenkanten direkt als geometrische Linien liefert. Damit ist es gelungen, die meisten Schienenkanten sehr zuverlässig zu erkennen.
Damit die drei Verfahren fair verglichen werden können, obwohl sie sehr unterschiedliche Ausgabeformate haben, wurde für die Bewertung eine gemeinsame Metrik verwendet. Die vom U-Net gelieferte Maske entspricht direkt einer Fläche. Bei den beiden linien-basierten Verfahren (Classical und LINEA) werden die zwei erkannten Kanten mit den seitlichen Bildrändern zu einem Viereck verbunden, welches ebenfalls als Fläche interpretiert wird. Für alle drei Verfahren wurde anschliessend diese Fläche mit der von Hand annotierten Referenz-Fläche verglichen. Als Metrik dient die Intersection-over-Union (IoU), also der Anteil der überlappenden Pixel im Verhältnis zur Gesamtfläche beider Regionen zusammen.
Die Ergebnisse zeigen deutliche Unterschiede: die klassische Kantenerkennung erreicht eine IoU von 0,77, das U-Net kommt auf 0,60 und das LINEA-Modell auf 0,96. Damit liefert das LINEA-Modell die mit Abstand präzisesten Kanten und ist für diese Aufgabe der klar geeignetste Ansatz.
Technische Schlüsselbegriffe
- Line Detection Direkte Vorhersage einzelner Linien als geometrische Objekte mit Anfangs- und Endpunkt.
- Semantische Segmentierung Pixelweise Klassifikation eines Bildes in Klassen wie „Schiene" oder „Hintergrund".
- Transformer-Architektur Neuronales Netzwerk mit Attention-Mechanismus.
- Canny Edge Detection Klassisches Verfahren zur Erkennung von Bildkanten anhand lokaler Gradienten.
- Hough-Transformation Klassisches Verfahren zur Erkennung von Geraden aus einer Menge von Kantenpixeln.
- Intersection-over-Union Metrik für den pixelweisen Überlappungsanteil zweier Flächen (0 = disjunkt, 1 = deckungsgleich).
Team
Studierende
Adrian Meier
Raphael Schüpbach
Betreuer
Susanne Suter
Andrea Sacchetti