
Educational Programming Agent
Ein KI-Tutor, der Programmieranfänger durch didaktisch fundiertes Feedback beim Verstehen ihrer Fehler unterstützt – ohne Fine-Tuning, realisiert mit gezieltem Prompt-Engineering. An AI tutor that supports beginner programmers in understanding their mistakes through pedagogically grounded feedback – no fine-tuning required, achieved through targeted prompt engineering.
Ausgangslage Initial Situation
Einführungskurse in die Programmierung gehören zu den anspruchsvollsten Lehrveranstaltungen im Informatikstudium. Anfänger kämpfen mit abstrakten Konzepten wie Variablen, Schleifen und Kontrollfluss und erhalten Fehlermeldungen, die mehr verwirren als erklären. Forschungsergebnisse zeigen, dass die meisten Lernenden zu Beginn fehlerhafte mentale Modelle davon besitzen, wie Programme ablaufen (Sorva, 2013). Der Lernprozess wird dadurch zu einer Folge von Trial-and-Error-Schritten, die selten zu einem konzeptuellen Verständnis führen. Introductory programming courses rank among the most demanding in computer science education. Beginners struggle with abstract concepts such as variables, loops and control flow, receiving error messages that confuse more than they explain. Research shows that most learners initially hold faulty mental models of how programs execute (Sorva, 2013). This turns the learning process into a series of trial-and-error steps that rarely lead to conceptual understanding.
Gleichzeitig können Lehrpersonen in grossen Kursen kein personalisiertes, zeitnahes Feedback für alle Studierenden leisten. Klassische intelligente Tutorsysteme erfordern aufwändiges domänenspezifisches Fine-Tuning – eine hohe technische und finanzielle Einstiegshürde. At the same time, instructors in large courses cannot provide personalised, timely feedback to every student. Traditional intelligent tutoring systems require extensive domain-specific fine-tuning – a high technical and financial barrier to entry.
Problemstellung und Projektziel Problem Statement and Project Goal
Kann ein LLM-basierter Agent bewährte didaktische Methoden – wie Scaffolding, sokratischen Dialog oder Bug-driven Learning – automatisch und adaptiv umsetzen, ohne dass ein kostspieliges Fine-Tuning nötig ist? Und wie lässt sich die Qualität solcher Interaktionen skalierbar und automatisiert messen? Can an LLM-based agent automatically and adaptively implement established pedagogical methods – such as scaffolding, Socratic dialogue or bug-driven learning – without costly fine-tuning? And how can the quality of such interactions be measured in a scalable, automated way?
Ziel dieser Bachelorarbeit war die Konzeption, der Aufbau und die systematische Evaluation eines Educational Programming Agent (EPA): ein Python-Tutor für Anfänger, der Lernende durch gezielte Rückfragen, Hinweise und Erklärungen zum eigenständigen Denken anregt – statt fertige Lösungen zu liefern. The goal of this bachelor thesis was the design, development and systematic evaluation of an Educational Programming Agent (EPA): a Python tutor for beginners that encourages independent thinking through targeted questions, hints and explanations – rather than delivering ready-made solutions.
Methodik: Die Evaluationspipeline Methodology: The Evaluation Pipeline
Das Vorgehen gliedert sich in drei aufeinander aufbauende Phasen. Klicken Sie auf einen Schritt für Details. The approach is structured in three sequential phases. Click a step for details.
DatensatzDataset
Synthetische Python-Fehler + menschliche AnnotationSynthetic Python errors + human annotation
LLM-as-a-Judge
Stimmen KI-Urteile mit menschlichen überein?Do AI judgements align with human ratings?
Prompt-Tuning
Iterative Verbesserung des EPA-VerhaltensIterative improvement of EPA behaviour
📝 Datensatz & Annotation📝 Dataset & Annotation
- 49 synthetische Python-Fehlerszenarien; in 2 Iterationen auf 67 Cases erweitert
- Fehlertypen: Syntaxfehler, logische Fehler, konzeptuelle Fehler, überkomplexe Lösungen
- Jede EPA-Antwort bewertet von 2 Human Annotators und 3 LLM-Judges (Gemini, OpenAI, Qwen)
- 6 Bewertungsdimensionen (S1–S6), Skala 1–5 (ordinal) bzw. binär
- 49 synthetic Python error scenarios; expanded to 67 cases across 2 iterations
- Error types: syntax errors, logic errors, conceptual errors, over-complex solutions
- Each EPA response rated by 2 human annotators and 3 LLM-judges (Gemini, OpenAI, Qwen)
- 6 evaluation dimensions (S1–S6), scale 1–5 (ordinal) or binary
⚖️ LLM-as-a-Judge Validierung⚖️ LLM-as-a-Judge Validation
- Spearman-Rangkorrelation zwischen LLM-Scores und menschlichem Durchschnitt berechnet
- Iteration I (geringe Varianz): Korrelation nahe null – Folge von Datensatz-Homogenität, nicht LLM-Versagen
- Iteration II (mehrere Prompts, höhere Varianz): Korrelation bei S1/OpenAI → 0.93; S3 und S5 → 0.75–0.86
- LLM-Judges eignen sich für die Scores S3 (Didaktik) und S5 (No Solution Dump) als automatisierte Evaluatoren
- Spearman rank correlation between LLM scores and human average computed
- Iteration I (low variance): correlation near zero – a consequence of dataset homogeneity, not LLM failure
- Iteration II (multiple prompts, higher variance): correlation on S1/OpenAI → 0.93; S3 and S5 → 0.75–0.86
- LLM-judges are suitable automated evaluators for S3 (Didactics) and S5 (No Solution Dump)
🔧 Iteratives Prompt-Tuning🔧 Iterative Prompt Tuning
- 8 Prompt-Strategien systematisch verglichen: Baseline, CoT, Few-Shot, Scaffolding, Socratic, Persona, Self-Critique, Master Prompt
- Bewertung durch validierte LLM-Judges auf S3 und S5
- S5: Solution-Dump-Rate von ~50% auf ~0–5% gesenkt (Socratic, Persona, Scaffolding, Master Prompt)
- S3: Didaktik-Score von 2.4 auf 2.9 gesteigert
- 8 prompt strategies systematically compared: Baseline, CoT, Few-Shot, Scaffolding, Socratic, Persona, Self-Critique, Master Prompt
- Evaluated by validated LLM-judges on S3 and S5
- S5: solution-dump rate reduced from ~50% to ~0–5% (Socratic, Persona, Scaffolding, Master Prompt)
- S3: didactics score improved from 2.4 to 2.9
Entwickelte Lösung und ihre Vorteile Solution Developed and Its Benefits
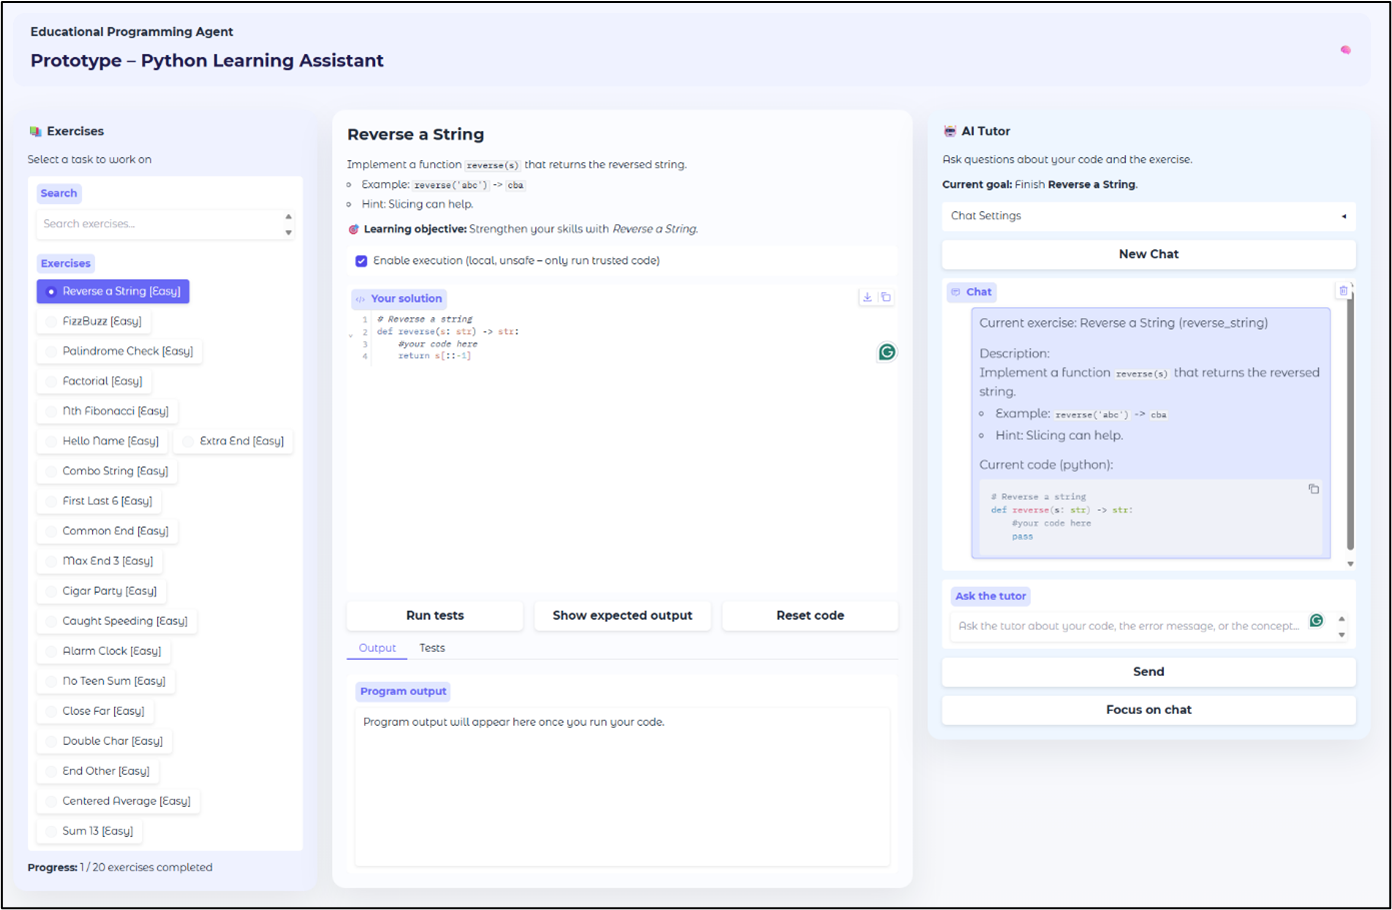
Der EPA ist ein webbasierter Lernassistent auf Basis von Gradio, der Python-Anfänger interaktiv beim Erkennen und Beheben von Fehlern begleitet. Er gliedert sich in drei Bereiche: Aufgabenauswahl (links), Code-Editor mit Ausführung (Mitte) und Chat mit dem Tutor-Agenten (rechts). Das didaktische Kernprinzip: keine fertigen Lösungen ausgeben, sondern durch Scaffolding, sokratische Fragen und strukturierte Hinweise das eigenständige Denken fördern. The EPA is a Gradio-based web learning assistant that interactively guides Python beginners in identifying and fixing their mistakes. It is divided into three areas: task selection (left), code editor with execution (centre) and chat with the tutor agent (right). Its central pedagogical principle: no ready-made solutions, but fostering independent thinking through scaffolding, Socratic questions and structured hints.
= und ==? Was macht jeder der beiden Operatoren?
Interesting! Look carefully at line 2: what is the difference in Python between = and ==? What does each operator do?
= ist Zuweisung und == ist Vergleich?
Oh... = is assignment and == is comparison?
print() in Python, und was macht return? Haben beide den gleichen Effekt auf den Wert, den eine Funktion «zurückgibt»?
What do you think: what does print() do in Python, and what does return do? Do they have the same effect on the value a function "gives back"?
print zeigt nur etwas an, gibt aber nichts zurück?
Uh... print just displays something but doesn't return a value?
result in deinem Code? Was passiert, wenn du versuchst, damit zu rechnen?
Very good! And if a function returns nothing – what value does result hold in your code? What happens when you try to do arithmetic with it?
Der EPA implementiert folgende didaktische Prinzipien durch Prompt-Engineering: The EPA implements the following pedagogical principles through prompt engineering:
- Scaffolding – schrittweise Unterstützung, die mit wachsender Kompetenz reduziert wirdstepwise support that is gradually reduced as competence grows
- Sokratischer DialogSocratic Dialogue – gezielte Rückfragen statt direkter Antwortentargeted counter-questions instead of direct answers
- Bug-driven Learning – Fehler als Lernmoment, nicht als Misserfolgerrors as learning opportunities, not failures
- Cognitive Apprenticeship – Modellierung von Expertenwissen, Coaching, schrittweises Fadingmodelling of expert knowledge, coaching, gradual fading
- Worked Examples – exemplarische Lösungswege, ohne die eigentliche Aufgabe zu lösenexemplary solution paths without solving the actual task
Ergebnisse Results
LLM vs. Human (S1)Spearman ρ
LLM vs. Human (S1)
nach OptimierungSolution-Dump Rate
after Optimisation
2.4 → 2.9Didactics Score
2.4 → 2.9
verglichenPrompt Strategies
compared
Prompt-Vergleich: Didaktik (S3) und Solution-Dump (S5)Prompt Comparison: Didactics (S3) and Solution Dump (S5)
Durchschnittliche LLM-Judge-Scores pro Prompt-Strategie. Tab wechseln, um Dimension zu ändern.Average LLM-judge scores per prompt strategy. Switch tab to change dimension.
LLM-Judge Korrelation mit Human Annotators (Iteration II)LLM-Judge Correlation with Human Annotators (Iteration II)
Spearman-Rangkorrelation nach Score und Modell. Hover für Detailwerte.Spearman rank correlation by score and model. Hover for detail values.
Bewertungsrubrik (S1–S6)Evaluation Rubric (S1–S6)
Alle EPA-Antworten wurden nach sechs Dimensionen bewertet – durch zwei menschliche Annotatoren sowie drei LLM-Judges.All EPA responses were evaluated on six dimensions – by two human annotators as well as three LLM-judges.
Aufgaben-KonsistenzTask Alignment
Stimmt die Antwort mit der Aufgabenstellung überein?Does the response align with the task?
Fragen-KonsistenzQuestion Alignment
Geht der EPA auf Code und Frage des Studenten ein?Does the EPA address the student's code and question?
DidaktikDidactics
Werden didaktische Prinzipien umgesetzt?Are pedagogical principles applied?
AnfängerfreundlichkeitBeginner-Friendliness
Ist die Sprache für Einsteiger geeignet?Is the language appropriate for beginners?
Kein Solution-DumpNo Solution Dump
Vermeidet der EPA das Ausgeben fertiger Lösungen?Does the EPA avoid delivering complete solutions?
Nächste SchritteActionable Steps
Bietet der EPA sinnvolle Folgeschritte an?Does the EPA provide meaningful next steps?
Prompt-Strategien im VergleichPrompt Strategies Compared
Klicken Sie auf eine Karte, um Details zur Strategie zu sehen.Click on a card to see details about the strategy.
Kernerkenntnis:Core Finding: LLM-basierte Agenten können didaktische Methoden wie Scaffolding und sokratischen Dialog wirksam umsetzen – ganz ohne domänenspezifisches Fine-Tuning. Gezieltes Prompt-Engineering reicht aus. Persona- und Zero-Shot-Prompts erzielen dabei nahezu die gleiche Qualität wie aufwändige Few-Shot-Ansätze – bei einem Bruchteil der Token-Kosten. Dies hat direkte Implikationen für EdTech-Unternehmen: wirksame KI-Tutoren sind ohne teure Modell-Anpassungen realisierbar. LLM-based agents can effectively implement pedagogical methods like scaffolding and Socratic dialogue – entirely without domain-specific fine-tuning. Targeted prompt engineering is sufficient. Persona and zero-shot prompts achieve nearly the same quality as elaborate few-shot approaches – at a fraction of the token cost. This has direct implications for EdTech companies: effective AI tutors are achievable without expensive model customisation.
SchlüsselbegriffeKey Terms
- LLM-as-a-JudgeAutomatisierte Qualitätsbewertung durch SprachmodelleAutomated quality evaluation using language models
- ScaffoldingSchrittweise Lernunterstützung, die mit Kompetenz abnimmtStepwise support that decreases as competence grows
- Prompt EngineeringSteuerung von LLM-Verhalten durch gezielte InstruktionenControlling LLM behaviour through targeted instructions
- Solution DumpUnerwünschtes direktes Ausgeben von Lösungscode durch den AgentenUndesired direct delivery of solution code by the agent
- EPAEducational Programming Agent – KI-Tutor für Python-AnfängerEducational Programming Agent – AI tutor for Python beginners
- Spearman ρRangkorrelationskoeffizient zur Messung von Annotator-ÜbereinstimmungRank correlation coefficient for measuring annotator agreement
TeamTeam
Dominik Scherrer
Oliver Pejic
BetreuungAdvisor
Fachhochschule Nordwestschweiz
Hochschule für Informatik
University of Applied Sciences Northwestern Switzerland
School of Engineering