
Entwicklung eines Token-basierten LibAFL Fuzzers für Bildverarbeitungsbibliotheken
Ein Token-Discovery Algorithmus um für Token-basierten LibAFL Fuzzer automatisch Tokens zu finden.
Ausgangslage
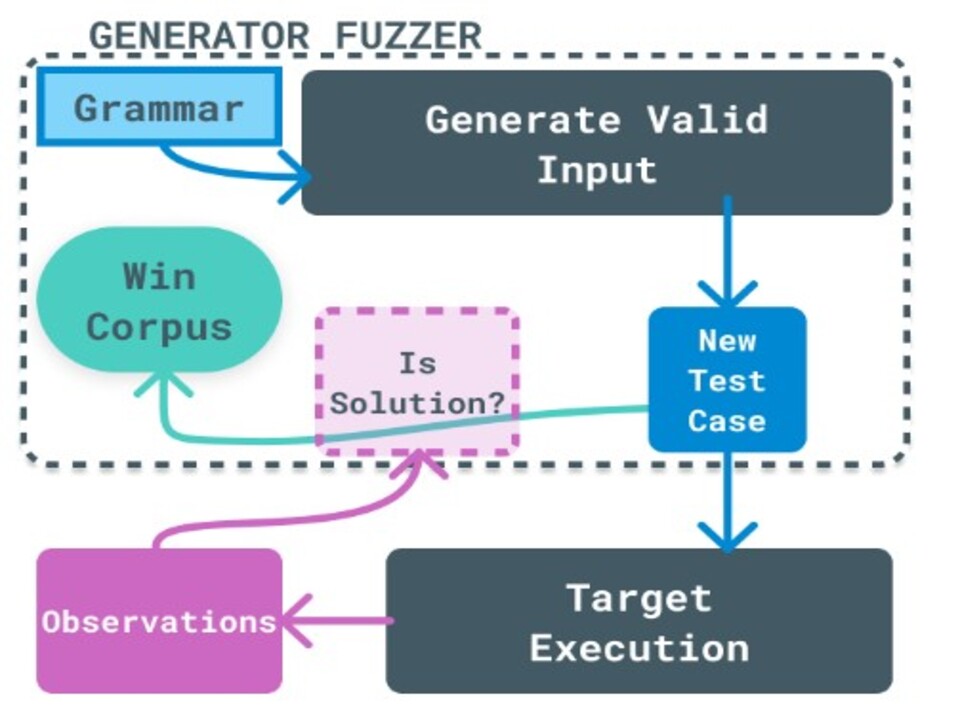
Fuzzers versuchen, mit zufälligen Inputs Bugs und Crashes in einem Programm zu finden. Dafür wurden mehrere Ansätze ausgearbeitet. Die simpelste Implementierung verändert dazu auf Byte-Level die Inputs, um dadurch zufällige Inputs zu generieren. Ein anderer Ansatz versucht, mit grammatikbasierendem Fuzzing syntaktisch korrekte Inputs zu generieren, sodass mehr richtige Inputs getestet werden können. Der Mittelweg dieser Ansätze ist der tokenbasierte Fuzzer. Dieser enkodiert den Input als zufällige Tokens und ändert diese mit bekannten, manuell eingetragenen Tokens.
Zielsetzung
In diesem Projekt sollte ein neuer tokenbasierter Ansatz ausgearbeitet werden, welcher automatisch durch Coverage Feedback neue Tokens generiert. Dadurch müssten diese nicht mehr manuell eingetragen werden. Coverage Feedback beschreibt hier den Mechanismus, welcher analysiert welche Codeteile ausgeführt werden. Der Fuzzer wertet die Ergebnisse der Testfälle aus und leitet daraus ab, welche bisher unerforschten Code-Pfade erreicht wurden. Die grundlegende Idee besteht darin, dass jeder neue Pfad potenziell unentdeckte Fehler oder Schwachstellen enthalten kann.
Dazu sollte die Open-Source Bibliothek LibAFL benutzt werden, welche bereits Fuzzers und ein fortgeschrittenes Coverage-Feedback besitzt.
Bild 1
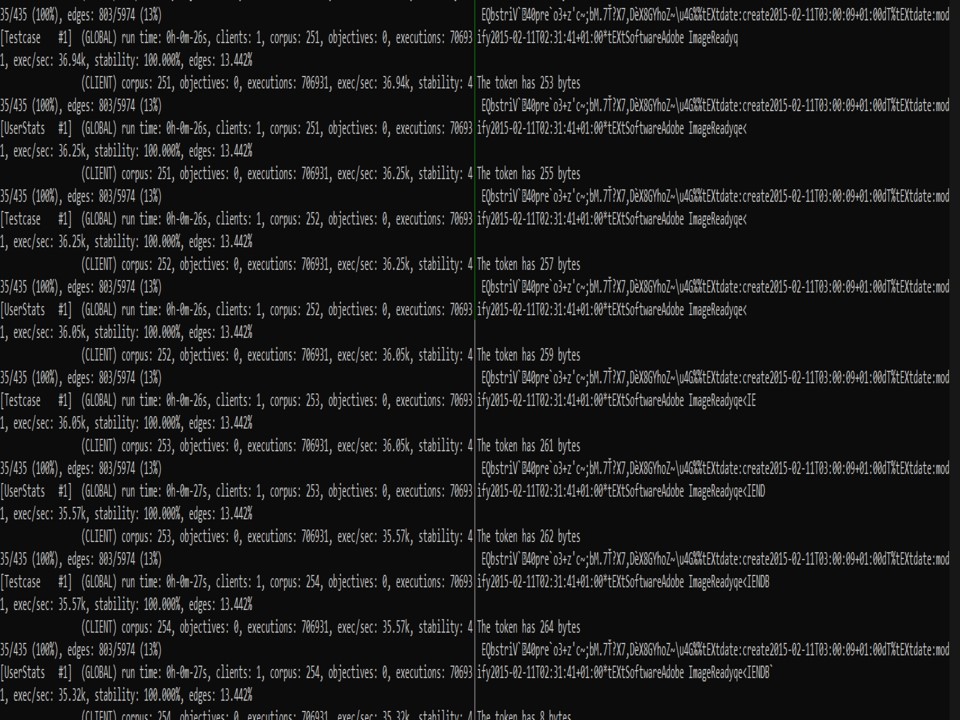
Auschnitt aus einem laufenden Fuzzer. Links der aktuelle Fortschritt und rechts die gefundenen Tokens
Bild 2
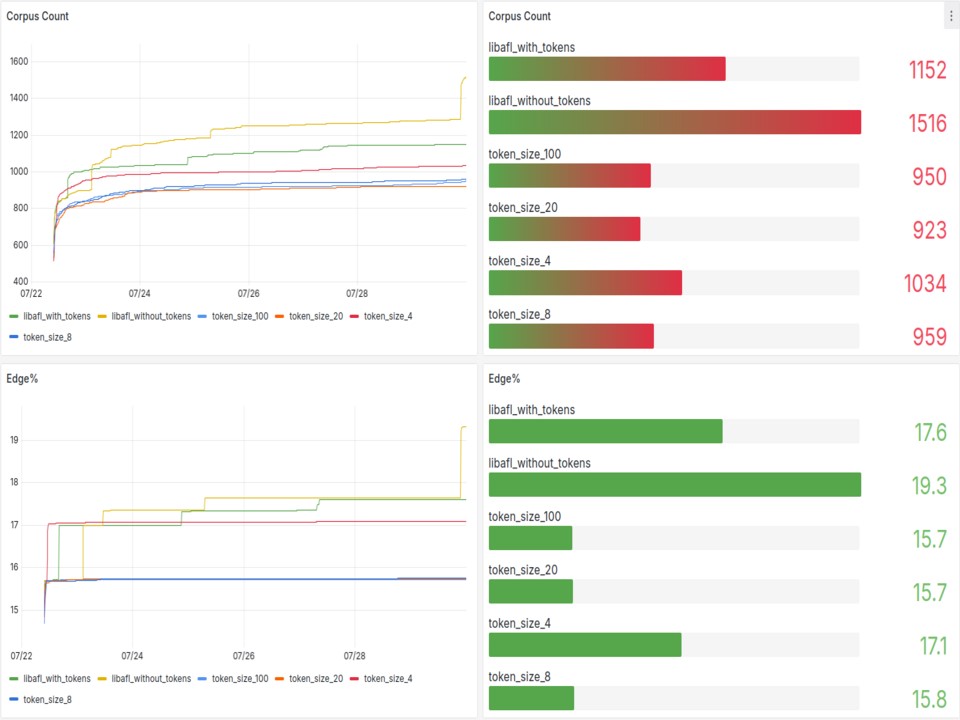
Resultate der Implementierung bezogen auf die Code Coverage und die Anzahl interessanten Inputs(Corpus) von der Token Grösse
Bild 3
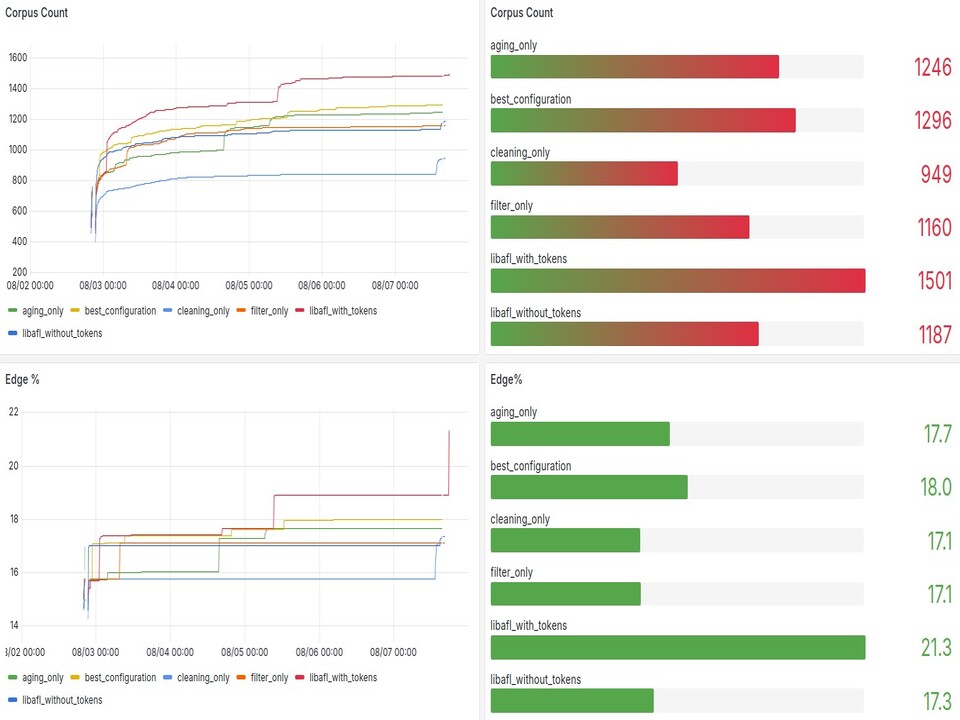
Resultate der Code Coverage und die interessanten Inputs(Corpus) der Verfeinerungs Methoden
Ergebnisse
Ein erfolgreicher Token-Discovery Algorithmus konnte implementiert werden, welcher neue Tokens automatisch findet und benutzt mithilfe von Coverage Feedback. Zusätzlich wurden Verfeinerungs Methoden entwickelt, um den Prozess zu beschleunigen bzw. effizienter zu machen, wie Token-Cleaning oder Token-Aging.
- Durch Coverage-Feedback Tokens finden
- Gefundene Tokens in Token-Liste hinzufügen, um in späteren Iterationen benutzt werden zu können
- Verfeinerungs Methoden, um den den Algorithmus effizienter und schneller zu machen.
Der Code zu diesem Projekt ist auf Github.
Technische Schlüsselbegriffe
- Fuzzerautomatisierte Technik für Softwaretests
- Token-Level wird auf Token Level gefuzzt
- RustBenutzte Programmiersprache
- LibAFLDie LibAFL Bibliothek wird benutzt um zu fuzzen
Team
Alessandro Lenti
Hoang Viet Nguyen
Betreuerin
Christopher Scherb