Tinder for your home - Identifikation visueller Produktähnlichkeiten für Webshops mit
Deep Learning
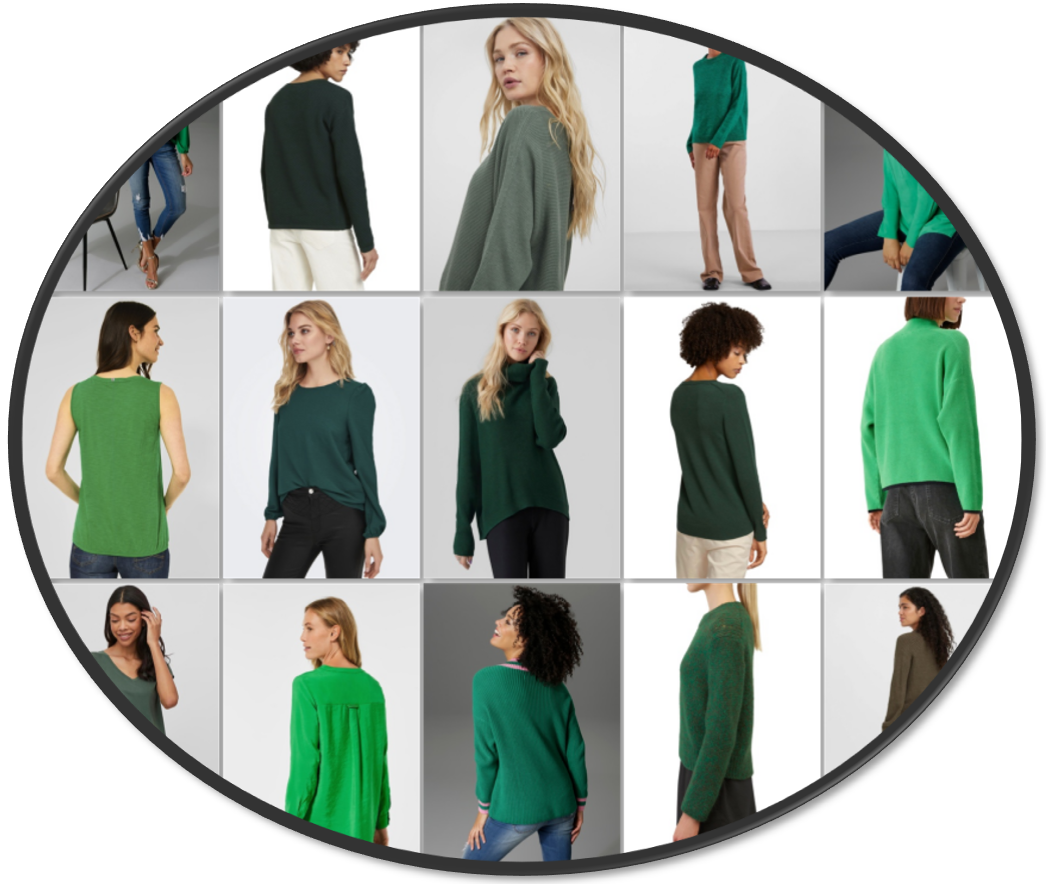
Produktbildvorschläge für das zentrale Referenzbild, spiralförmig angeordnet.
Zusammenfassung
Die Arbeit evaluiert unterschiedliche Ansätze zur Berechnung von Produktähnlichkeiten auf Basis von Produktbildern,
um den bestehenden Ansatz des Kunden robuster gegenüber Störfaktoren zu machen.
Es wurden unterschiedliche Ansätze zur Berechnung von Produktähnlichkeiten anhand von Produktbildern
evaluiert und den Einfluss der modellierten Bildsegmentierung auf die Vorhersage ähnlicher Produkte untersucht.
Zur Verbesserung der Ähnlichkeitsberechnung wurden sechs Varianten in einer Umfrage evaluiert.
Das beste Modell war das CLIP-Modell, das auf segmentierten Produktbildern trainiert wurde und den bestehenden Ansatz zur Ähnlichkeitsberechnung stark verbesserte.
Für die Adaption auf Amateuraufnahmen kann die Bildsegmentierung verwendet werden, um die Vorhersage der ähnlichen Produkte weiter zu verbessern.
Freistellung der Webshop Produktvisualisierungen aus ihrem Hintergrund
Anwenden und Vorselektionieren von visuellen Deep Learning Ähnlichkeitsansätzen
Evaluieren der Freistellung und Ähnlichkeitsansätze gegenüber der bestehenden Methode
Ausgangslage
InnoFind GmbH hat einen Ansatz zur Empfehlung von freigestellten Produkten auf professionellen Produktbildern entwickelt.
Jedoch beeinflussen Faktoren wie Hintergrund, Aufnahmewinkel und Auflösung die Produktähnlichkeit in der aktuellen Implementierung.
Daher sollen in dieser Arbeit unterschiedliche Ansätze zur Berechnung von Produktähnlichkeiten anhand von Produktbildern evaluiert werden,
um den bestehenden Ansatz robuster zu gestalten.
Außerdem kann der Einfluss der bestehenden Ähnlichkeitsberechnung in Frage gestellt werden,
um die Vorhersagen ähnlicher Produkte zu verbessern.
Ergebnisse
Die Bildsegmentierung mit einem Mask R-CNN Modell erreichte auf einem Testdatensatz eine Erkennungsrate von 95,8%
und einen intersection over union (IoU) von 0,863.
Es wurden unterschiedliche Ansätze zur Berechnung von Produktähnlichkeiten anhand von Produktbildern evaluiert,
um den bestehenden Ansatz robuster gegenüber Störfaktoren zu machen.
Es konnte engegen der Erwartung kein signifikanter Unterschied zwischen Empfehlungen auf unsegmentierten und segmentierten Daten festgestellt werden.
Der Ansatz, das CLIP Modell für das Generieren von Embedding-Vektoren zu nutzen, zeigte sich als sehr erfolgsversprechend.
Daraus konnten viel bessere kontextbasierte Ähnlichkeiten gefunden werden.
Referring Image Segmentation Ansätze wie CRIS oder CLIPseg haben Potenzial für die Problemstellung und können Objekte bisher unbekannter Kategorie bereits ohne fine-tuning freistellen.
Um die Berechnung der Ähnlichkeiten zu beschleunigen, könnten weniger grosse Produktkategorien gewählt werden.