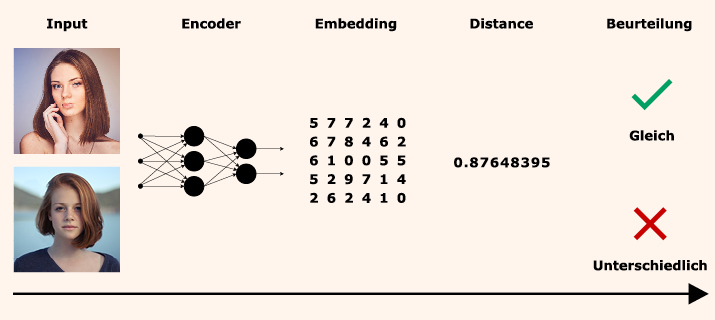
In diesem Projekt wurde untersucht, wie viele Daten benötigt werden, um mit Deep Learning zwei Gesichter miteinander vergleichen zu können.
Deep Learning, Python, Keras, TensorFlow
Das Ziel dieser Arbeit war es, zu untersuchen, wie sich unterschiedliche Embeddinggrössen auf die Genauigkeit der Gesichtsverifizierung auswirken.
Im Kontext eines Projektes an der Fachhochschule Nordwestschweiz steht zur Aufgabe, mittels Deep Learning möglichst kleine Repräsentationen von Gesichtern (Embeddings) zu generieren. Die Embeddings dienen dazu, die Ähnlichkeit von zwei Gesichtern anhand der euklidischen Distanz zu bestimmen und bestehen aus mehreren 32-Bit Floats. Die Embeddinggrösse bezeichnet die Anzahl der Floats eines Embeddings.
Es hat sich gezeigt, dass ein grösseres Embedding nicht zwingend mit besserer Modellperformance einhergeht. Das Embedding der Grösse 64 stellt sich als guter Kompromiss zwischen Embeddinggrösse und erzielter Accuracy heraus. Entgegen der Erwartungen zeigte sich, dass der Triplet Loss schlechtere Ergebnisse bei gleicher Inputgrösse ergibt als der Sparse Categorical Crossentropy Loss.
Projektdauer: Februar 2021 - August 2021
Aufwand: 720h
Teamgrösse: 2
Institut für Data Science, Fachhochschule Nordwestschweiz
Marc Berger und Nils Müller
Prof. Dr. Martin Melchior, martin.melchior@fhnw.ch
Marco Willi, marco.willi@fhnw.ch