Unstrukturierte Rückweisungstexte mithilfe von NLP klassifizieren
NLP, Textklassifikation, hierarchische Klassifikation, sklearn, TensorFlow, Deep Learning, CNN, Flask-API mit Docker
Die Auftraggeberin möchte ein System, das aufgrund der Rückweisungstexte von Versicherungen Vorschläge für die sogenannten Anfrage- und Themencodes macht.
Im Rahmen der Arbeit wird untersucht, ob es zuverlässig möglich ist, mit Machine Learning Methoden die Freitext-Rückweisungen in die richtigen Codes zu klassifizieren.
Die Arbeit umfasst die Datenanalyse und die Erstellung eines oder mehrerer, geeigneter Modelle für die Klassifizierung.
In Absprache mit der Auftraggeberin, ist besonders interessant, dass die entwickelten Modelle genaue Vorhersagen machen und keinen Code vorschlagen soll, wenn sich das Modell
nicht genug sicher ist. Mit geeigneten Experimenten und Modellvergleichen soll ein optimaler Prototyp erstellt werden.
Um das Modell im Arbeitsalltag zu integrieren, soll zusätzlich ein API-Service eingeplant werden, um aus dem internen Rechnungstool auf das erlernte Modell zugreifen zu können.
Das Universitätsspital Basel klassifiziert die Texte aus den anfallenden Rückweisungen der Versicherungen bis heute aufwändig von Hand und beurteilt diese für die Weiterverarbeitung.
Diese Zuweisung nimmt Zeit in Anspruch und benötigt gut geschultes Personal. Im Rahmen dieser Arbeit soll untersucht werden, wie präzise und vollständig die Rückweisungstexte maschinell und automatisiert
klassifiziert werden können.
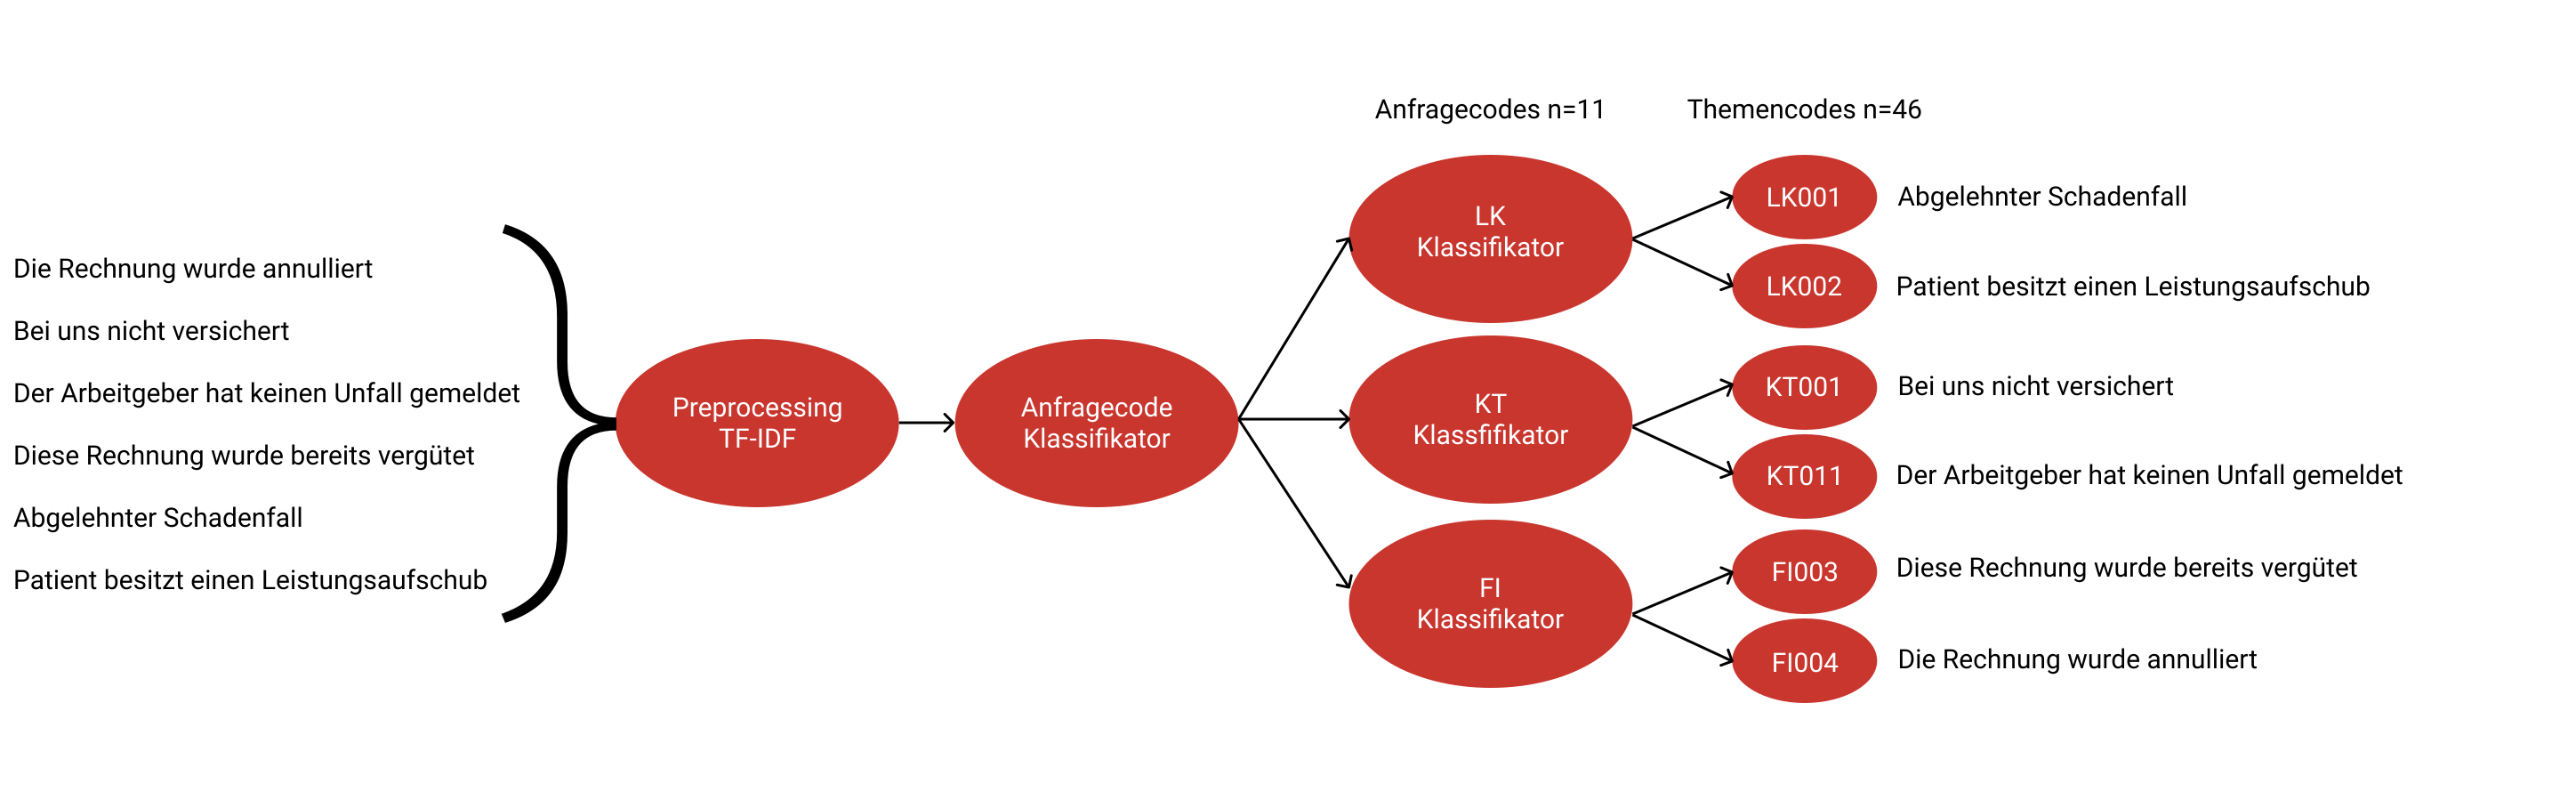
Der ausgehändigte Datensatz umfasst 135'000 Rückweisungen. Die Rückweisungen besitzen einen sogenannten Anfragecode der die Rückweisungen grob unterteilt.
Jeder Anfragecode selbst ist wieder in mehrere Themencodes unterteilt. So besitzt jede Rückweisung mindestens ein Anfrage- und einen Themencode. Aus den Anfrage- und Themencodes
kann abgelesen werden, zu welcher interne Abteilung die Rückweisung weitergeleitet werden muss. Die Rückweisungen sind sehr unausgeglichen über die Anfrage- und Themencodes verteilt.
Die explorative Datenanalyse hat gezeigt, dass die Daten sehr unstrukturiert und heterogen sind.
Mit einem Vergleich von drei verschiedenen Varianten wurde das beste Modell gesucht.
Betrachtet wurden ein lineares Modell, ein hierarchisches Modell und ein Deep Learning Modell.
Das hierarchische Modell hat am besten abgeschnitten.
Ein hierarchische Modell eignet sich sehr gut für dieses Problem, da die Klassen auch einer Hierarchie unterliegen.
Ebenfalls haben bei diesem Modell die bessere Precision und flach abfallende Recallkurve überzeugt.
Das hierarchische Modell kann im Testdatensatz 47 % der Rückweisungen mit einer Precision von 97 % klassifizieren.
Auf 100 Rückweisungen kann das Modell 47 Rückweisungen klassifizieren und macht dabei ungefähr 1,5 Fehler.
Das ist sogar etwas kleiner als die 1,8 Fehler die durch manuelle Klassifikation entstehen.
Der Prozess im Universitätsspital kann durch das erstellte Modell ergänzt werden. An Stellen wo sich das Modell bei der Klassifikation noch unsicher ist, greift der bestehende manuelle Prozess ein.
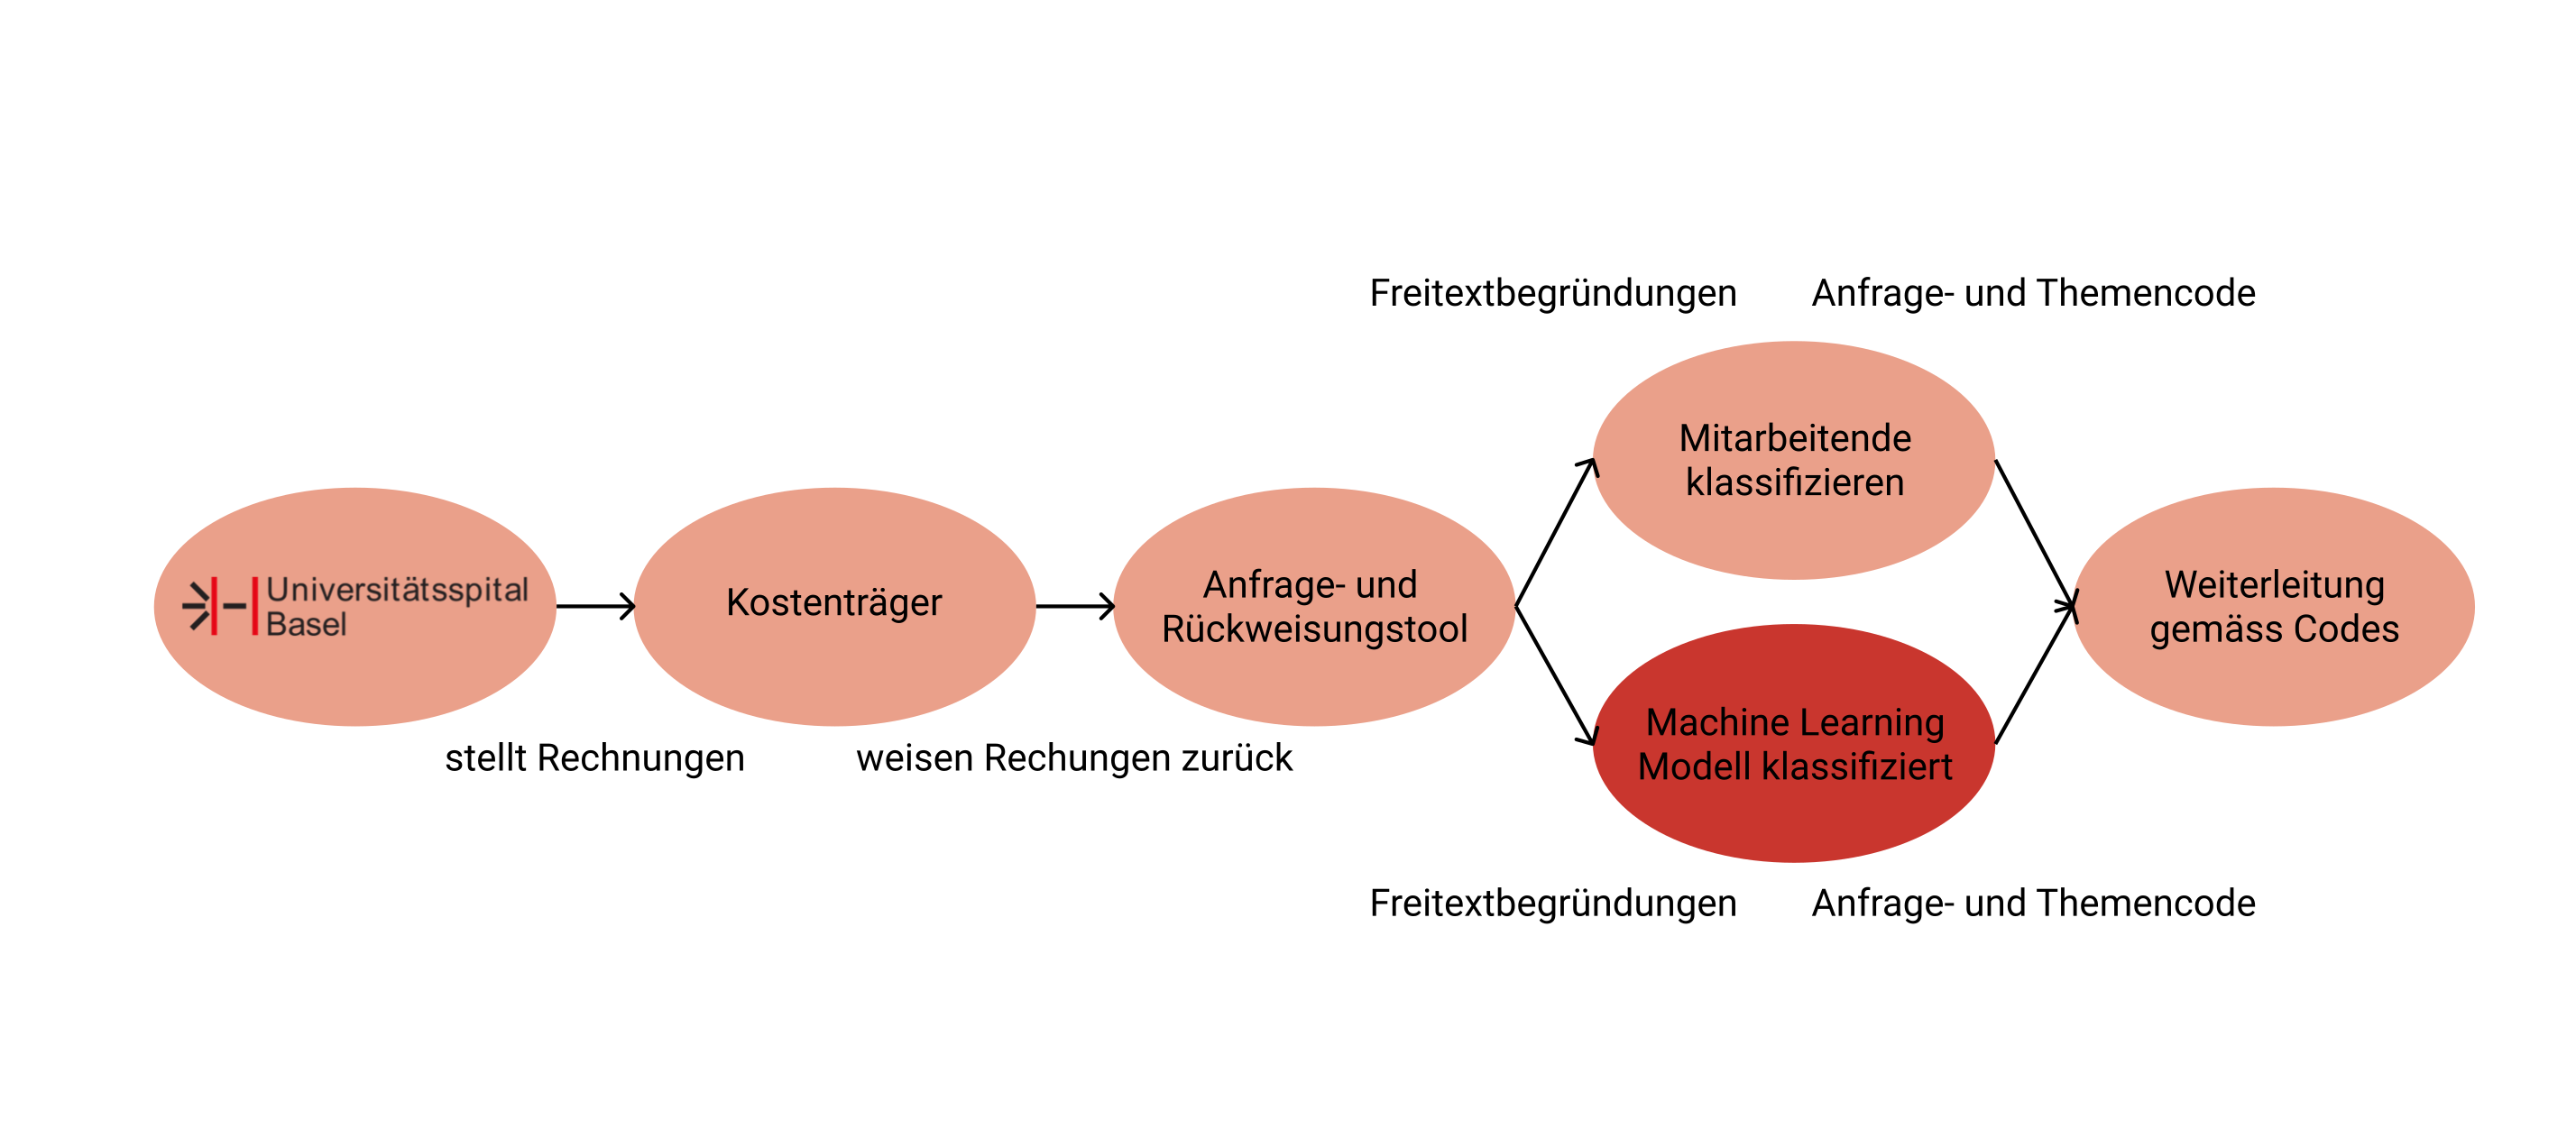
Diese Arbeit hat gezeigt, dass Machine Learning auf unstrukturierten Textdaten aus dem Gesundheitswesen möglich ist. Der Prototyp ist in einem API in Docker direkt einbindbar.
Universitätsspital Basel
Ressort Finanzen, Patientenmanagement, Support Center Abrechnung
Anika Züchner
anika.zuechner@usb.ch