
Minergie: Messdatenerfassung und Auswertung optimieren
Seit 2021 liefern Minergie-Gebäude laufend Messdaten, aus denen jedes Jahr Kennzahlen zum Betrieb entstehen. Weil der Datenbestand schneller wächst als die heutige Auswertung dafür ausgelegt ist, prüft diese Arbeit, ob eine Zeitreihen-Datenbank die Aufbereitung übernehmen kann.
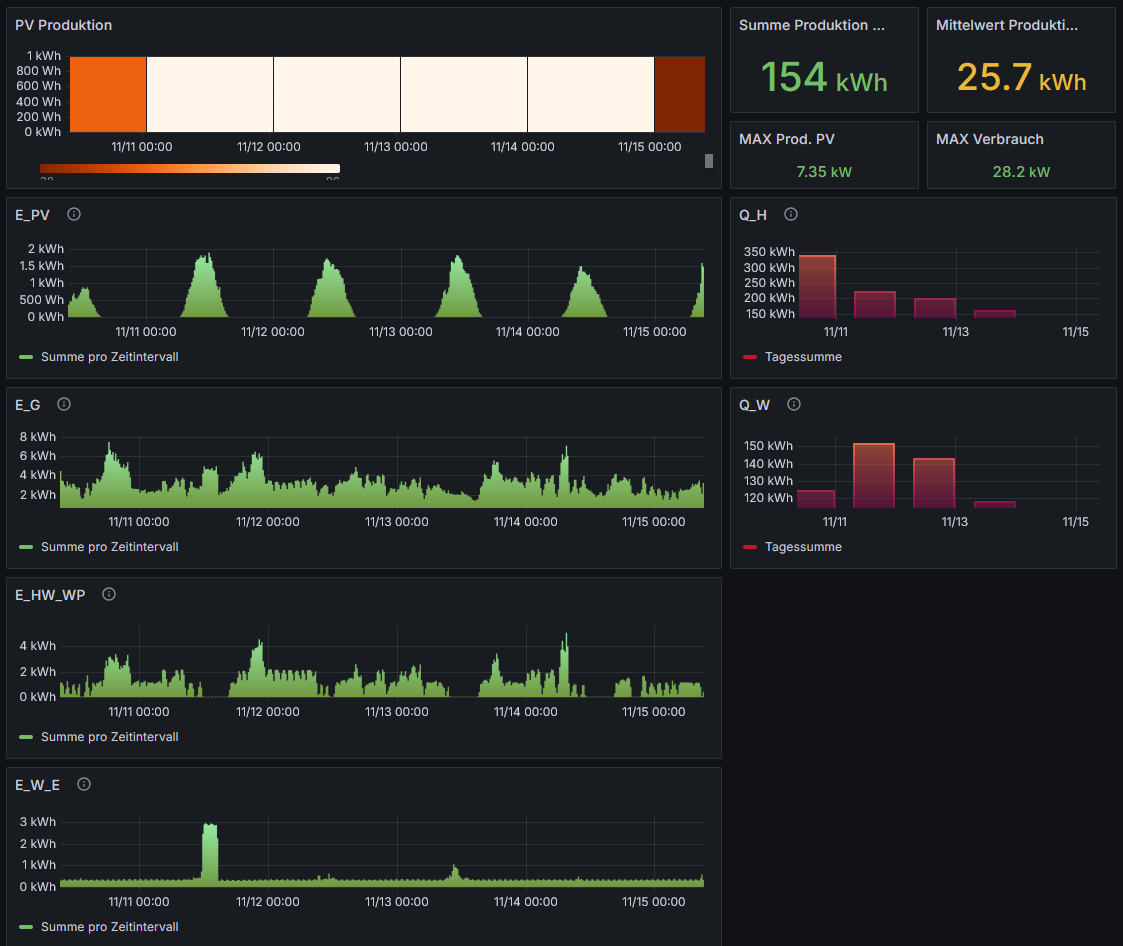
So sehen die Messdaten eines angeschlossenen Gebäudes aus, hier über fünf Tage. Aus solchen Reihen entstehen die jährlichen Kennzahlen. Quelle: Projektausschreibung.
Ausgangslage
Der Verein Minergie Schweiz vergibt Standards für Gebäude und betreibt seit 2021 den Dienst Minergie-Monitoring+. Angeschlossene Gebäude liefern laufend Messdaten, die einmal jährlich ausgewertet und den Werten aus dem Minergie-Nachweis gegenübergestellt werden. Die daraus gebildeten Kennzahlen heissen Benchmarks und zeigen, wie gut sich ein Gebäude im Betrieb gegenüber seiner Planung verhält.
Technische Grundlage ist die 2020 entwickelte Minergie-Monitoring-Datenbank, die von der Ateleris GmbH im Auftrag des Vereins betrieben wird. Sie nimmt die Rohdaten der Messdienstleister entgegen, legt sie in einem Microsoft SQL Server ab und berechnet die Kennzahlen erst dann, wenn die Label-Plattform eine Auswertung anfordert. Das Auffüllen von Lücken und das Zusammenfassen der Messreihen fallen damit mitten im Anfragepfad an.
Für diese Arbeit stand ein anonymisierter Abzug des produktiven Bestands mit Stand 19. März 2026 zur Verfügung. Er umfasst 18'350'381 Messwerte aus 406 Datenreihen von 64 Gebäuden, wovon 400 Reihen aktiv sind, und die älteste Messung stammt vom 4. Juni 2019. Wie fein eine Reihe aufgelöst ist, geht dabei weit auseinander, denn 279 liefern Viertelstundenwerte, 124 Tageswerte und 3 Jahreswerte.
Minergie rechnet mit einem Zuwachs von bis zu 500 Gebäuden pro Jahr. Hochgerechnet aus dem Jahr 2025, in dem 62 Gebäude rund 112'000 Messwerte je Gebäude lieferten, entspricht das rund 56 Millionen zusätzlichen Messwerten jährlich und damit etwa dem Dreifachen des heutigen Gesamtbestands, wiederkehrend in jedem Betriebsjahr. Die Historie muss dabei erhalten bleiben, weil die Kennzahlen jedes Jahr neu gerechnet werden.
Aus dem Betrieb sind drei Schwachstellen bekannt. Die Auswertung skaliert nicht so mit der Datenmenge, wie es das erwartete Wachstum verlangt. Aufwendig wird ausserdem das Zusammenführen von Reihen mit unterschiedlichem Zeitraster, was bei der beschriebenen Mischung der Regelfall ist. Als dritte Schwachstelle lässt sich die Qualität der Rohdaten nur beschränkt prüfen, sodass häufig von Hand korrigiert werden muss.
Ein akuter Engpass besteht heute nicht, denn eine Anfrage der Label-Plattform wird im Mittel in rund 1.6 Sekunden beantwortet. Anlass der Arbeit ist das erwartete Wachstum, dem vorsorglich begegnet werden soll, bevor daraus ein Engpass entsteht.
Zielsetzung
Die Arbeit geht der Frage nach, wie ein System aufgebaut werden kann, das Messdaten einliest, validiert, voraggregiert und anschliessend über eine geeignete Schnittstelle effizient für die Benchmark-Algorithmen bereitstellt. Diese vier Schritte gliedern Analyse, Konzept und Umsetzung in derselben Reihenfolge.
Der Gedanke dahinter ist, die Aufbereitung aus dem Anfragepfad herauszulösen und vorzuziehen, sodass die Benchmark-Algorithmen fertige Reihen vorfinden, statt sie erst bei der Anfrage zu erzeugen. Geeignet aufbereitet heisst dabei zweierlei. Ausreisser sind erkannt und fliessen nicht unbemerkt in die Kennzahlen ein, und die Reihen liegen bereits auf einem gemeinsamen Zeitraster zusammengefasst vor.
Entstehen soll eine Entscheidungsgrundlage für Minergie Schweiz und die Ateleris GmbH und kein einsatzfertiges Produkt. Woran sich der Prototyp messen lassen muss, gibt die bestehende Lösung vor, die eine vollständige Auswertung eines Gebäudes im Mittel in 1604 Millisekunden liefert. Dieser Wert ist die Obergrenze, während eine Verkürzung der Antwortzeit ausdrücklich kein Ziel ist, weil es um die Skalierbarkeit geht.
Heute
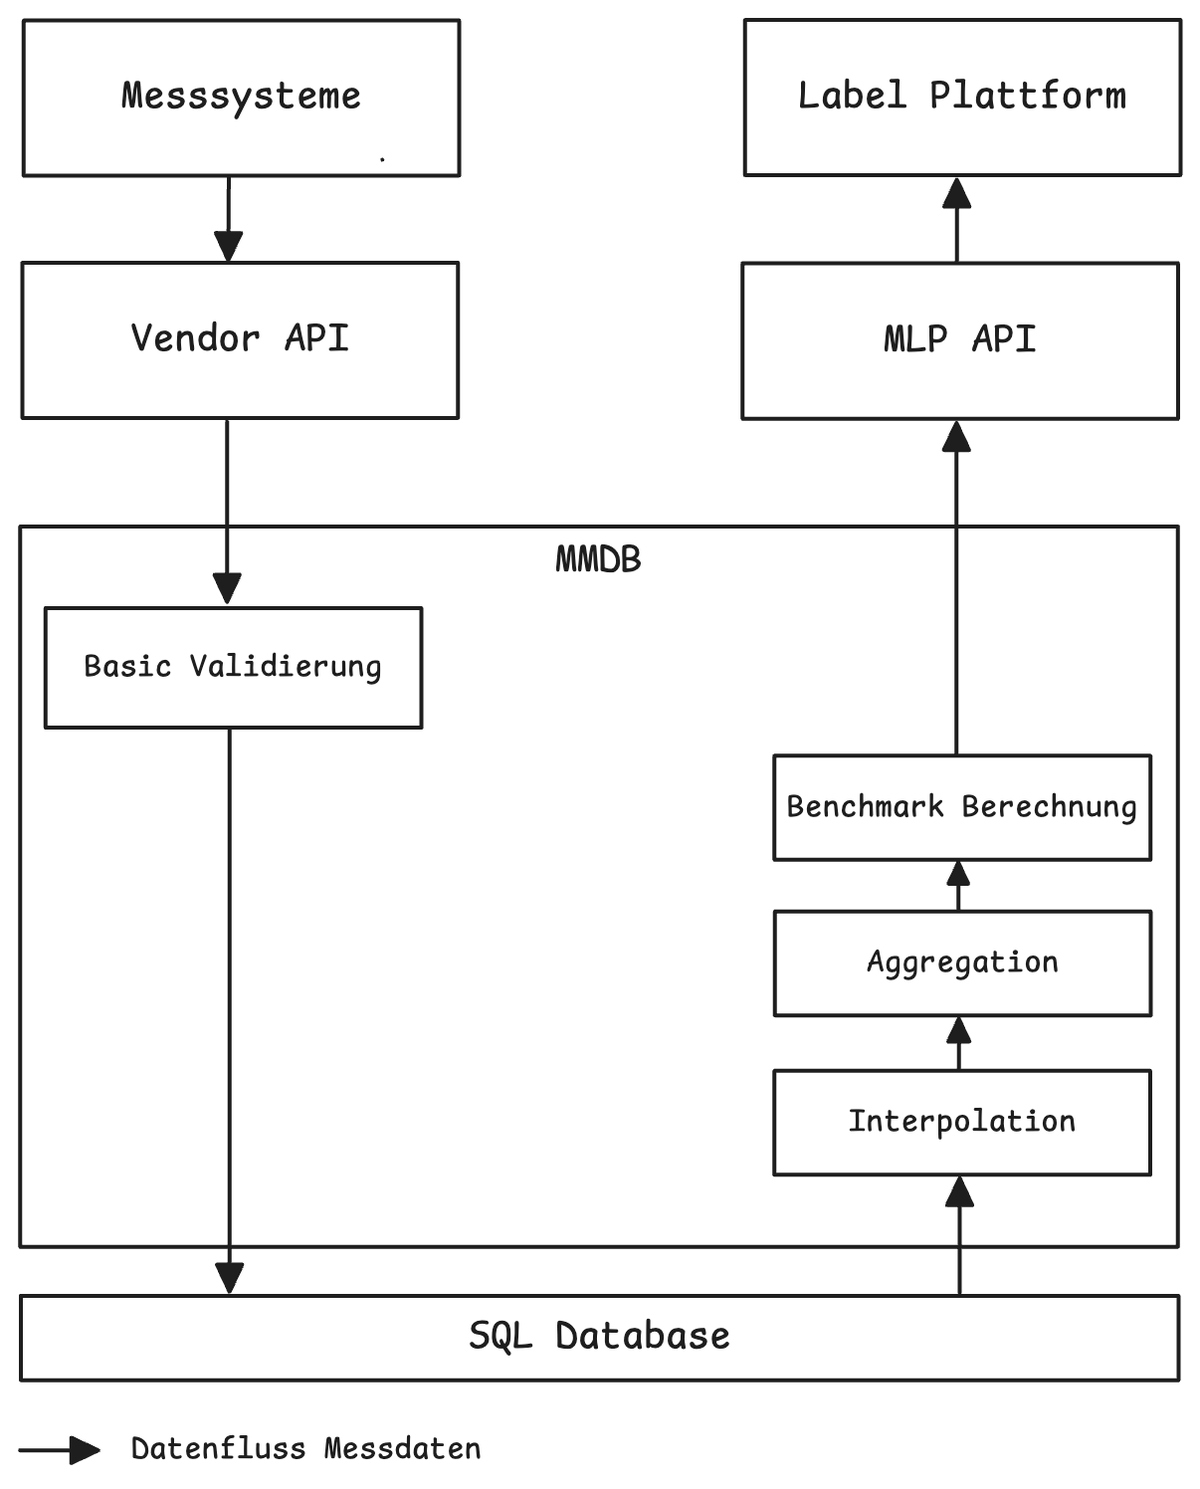
Die Aufbereitung liegt im Anfragepfad. Auffüllen, Zusammenfassen und Berechnen der Kennzahlen laufen erst an, wenn die Label-Plattform eine Auswertung anfordert.
Der Vorschlag
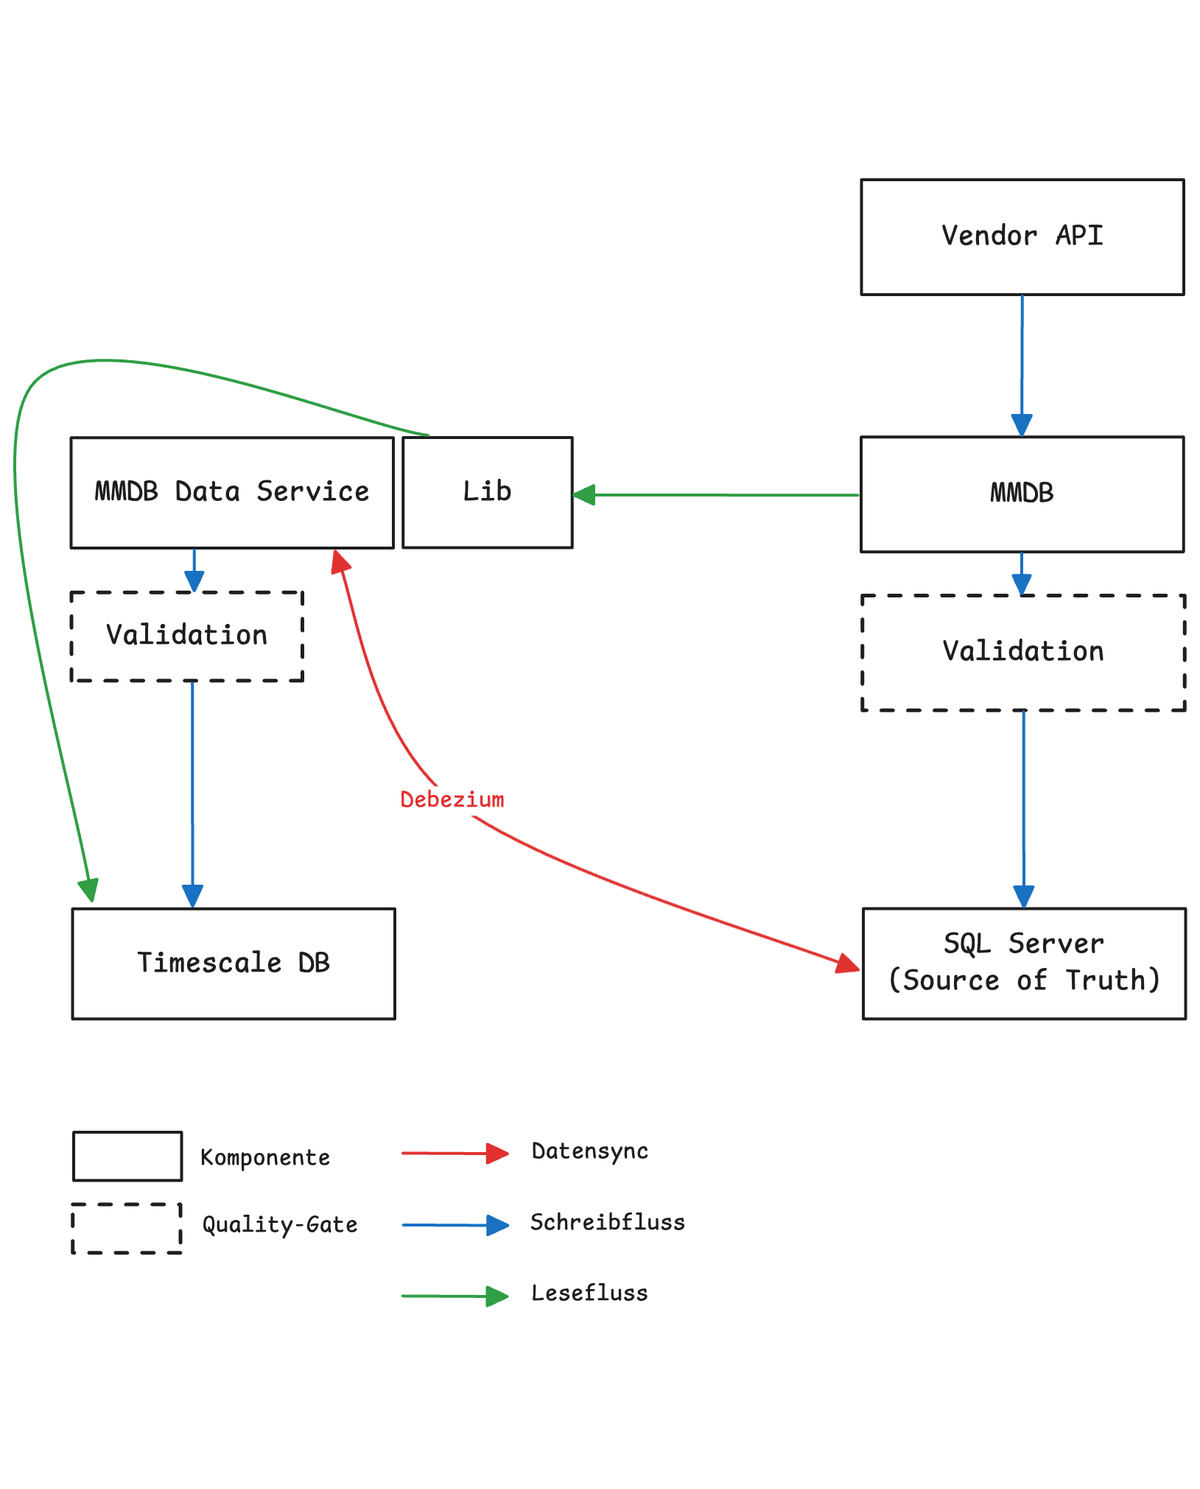
Ein eigener Datendienst hört Änderungen der bestehenden Datenbank ab und schreibt die Messwerte laufend in eine Zeitreihen-Datenbank. Der Weg der Rohdaten bleibt unverändert.
Das Messergebnis
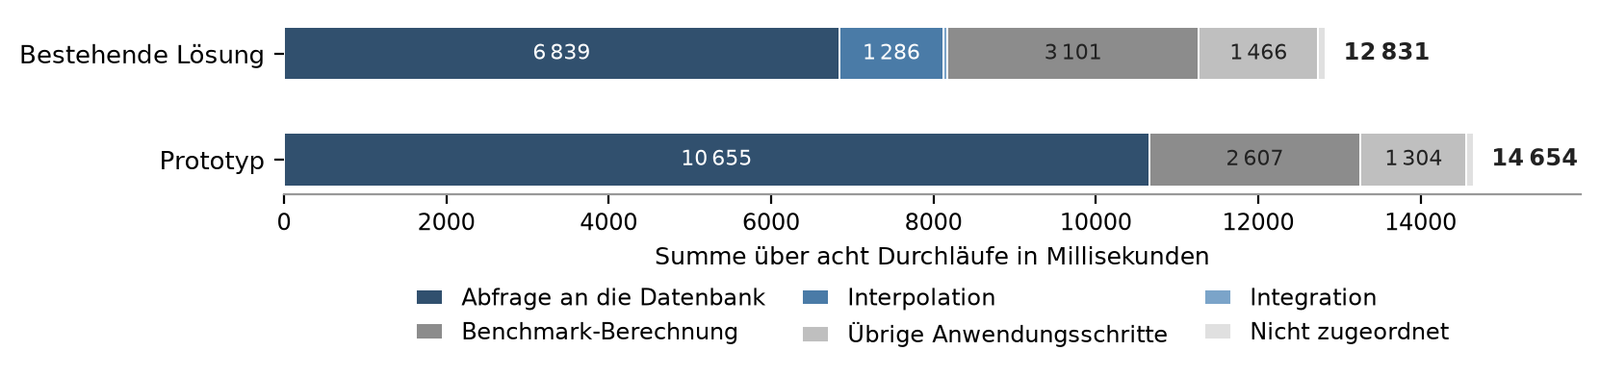
Summen über acht Durchläufe in Millisekunden. Im Prototyp fällt die gesamte Aufbereitung in einer einzigen Datenbankabfrage an, wo die bestehende Lösung drei getrennte Schritte braucht.
Ergebnisse
Für die Datenhaltung wurden acht Zeitreihen-Datenbanken betrachtet und drei davon vertieft geprüft, nämlich TimescaleDB, QuestDB und InfluxDB 3 Core. Kriterien und Gewichtung standen vor der Bewertung fest, damit das Ergebnis nachvollziehbar aus ihnen folgt. Die gewichtete Bewertung ergab 4.45 von 5 Punkten für TimescaleDB, 3.70 für QuestDB und 1.30 für InfluxDB 3 Core.
Den Ausschlag gab die Einbettung in das bestehende System. TimescaleDB erweitert die verbreitete Datenbank PostgreSQL, weshalb der vorhandene Datenzugriff aus Java weiterverwendbar bleibt und Stamm- und Messdaten ohne zusätzliche Infrastruktur in derselben Datenbank liegen. InfluxDB 3 Core schied aus, weil das automatische Zusammenfassen der Speicherdateien der kostenpflichtigen Ausgabe vorbehalten ist und Abfragen über den vollen Bestand deshalb scheiterten.
Entstanden ist ein Prototyp aus einem Datendienst auf Basis von Java und Spring Boot, der Erfassung von Datenbankänderungen mit Debezium und einer Bibliothek, welche die Benchmark-Algorithmen an die neue Datenhaltung anschliesst. Geliefert wurde:
- Eine Evaluation von drei Zeitreihen-Datenbanken mit vorab festgelegter Gewichtung der Kriterien.
- Der laufende Abgleich beider Datenbestände über die Erfassung von Datenbankänderungen, sodass die bestehende Datenbank die massgebliche Quelle bleibt und sich die Zeitreihen-Datenbank jederzeit vollständig neu aufbauen lässt.
- Eine Bewertung der Datenqualität, die jeden einzelnen Messwert kennzeichnet und abfragbar macht, ohne einen Messwert zu verwerfen.
- Eine Schnittstelle, die Reihen unterschiedlicher Auflösung über eine einzige Abfrage zusammenführt und das Auffüllen von Lücken in derselben Anweisung erledigt.
- Eine Vermessung beider Lösungen unter gleichen Bedingungen, auf demselben Rechner und gegen denselben Datenbestand.
Die Verlagerung gelingt vollständig. Wo die bestehende Lösung je Datenreihe drei Arten von Operationen ausführt, kommt der Prototyp mit einer aus. Der erwartete Zeitgewinn bleibt trotzdem aus, denn eine vollständige Auswertung eines Gebäudes dauert im Prototyp 1832 Millisekunden gegenüber 1604 der bestehenden Lösung, jeweils im Mittel über acht Durchläufe. Die Obergrenze ist damit um 14.2 Prozent überschritten.
Die Ursache ist eingegrenzt. Innerhalb der Datenbank leistet die einzelne Abfrage mehr als zuvor und kostet dort wenig. Der Mehraufwand fällt ausserhalb an, weil die aufrufende Stelle der bestehenden Anwendung unverändert zweimal je Datenreihe zugreift, statt die vorhandene Sammelabfrage zu nutzen. Deren Umbau ist deshalb der erste technische Ansatzpunkt einer Weiterführung.
Für die Einbindung in die bestehende Anwendung mussten 16 Dateien angefasst werden, alle in der Schicht, welche die Messreihen zusammenfasst. Von den 47 Dateien der Benchmark-Algorithmen wurde dagegen keine einzige geändert, ebenso wenig die beiden Schnittstellen nach aussen und das bestehende Datenmodell. Beim Speicher liegt die Zeitreihen-Datenbank mit 2738 Megabyte um 11.5 Prozent unter den 3094 des SQL Servers, auf beiden Seiten unkomprimiert gemessen.
Die Bewertung der Datenqualität erfüllt ihren Zweck als Verfahren, trifft am Bestand aber nicht wie entworfen. 91 Prozent aller Kennzeichen stammen aus einer einzigen Prüfung, die einen unveränderten Zählerstand bemängelt, obwohl ein solcher bei einem aufsummierenden Zähler häufig richtig bedeutet, dass kein Verbrauch angefallen ist. Vor einem produktiven Einsatz sind die Prüfregeln deshalb nachzuziehen.
Die Empfehlung an den Auftraggeber lautet, den Ansatz weiterzuverfolgen, und zwar in drei Schritten in dieser Reihenfolge. Zuerst sind die Prüfregeln nachzuziehen. Danach ist die aufrufende Stelle umzubauen und die Schnittstelle um eine Sammelabfrage zu erweitern. Erst dann lohnt die Aufnahme des Betriebs, weil die Antwortzeit vorher nicht dort angegangen ist, wo sie anfällt.
Technische Schlüsselbegriffe
- Zeitreihen-DatenbankTimescaleDB, in der Evaluation geprüft auch QuestDB und InfluxDB 3 Core
- Bestehende DatenhaltungMicrosoft SQL Server
- ÄnderungserfassungDebezium, Change Data Capture
- AnwendungJava, Spring Boot
- UmgebungDocker Compose
- Datenbestand18'350'381 Messwerte aus 406 Datenreihen von 64 Gebäuden
- FachgebietGebäudemonitoring, Energiekennzahlen, Benchmarks
Kund:in
Verein Minergie Schweiz
Auftraggeber
www.minergie.ch
Ateleris GmbH
Entwicklung und Betrieb der Minergie-Monitoring-Datenbank
www.ateleris.ch
Team
Nicolas Yates
Youri Weber
Betreuung
Prof. Dr. Jürg Luthiger
Matthias Krebs