Aus Projektdaten von 10 Jahren wurden Modelle zur Vorhersage von KPIs kreiert.
Machine Learning, KPIs, ETL, Jira, Kotlin, Spring Boot, Python, ScikitLearn, Keras, Angular, MongoDB, Elasticsearch, Kibana, Flask, Klassifizierung, Regression, Simulation, Vorhersage, Micro-Services, Cloud, Docker
Die vorhandenen Projektdaten der Firma sollen automatisch aus dem Projektmanagement-Tool Jira exportiert, aufbereitet und visualisiert werden. Aus diesen Daten sollen dann KPIs (Key Performance Indikatoren) berechnet und prognostiziert werden. Damit wird Projekt Managern nicht nur das Controlling stark vereinfacht, sondern es wird ihnen auch ermöglicht, frühzeitig Trends zu erkennen und so proaktiv die eingesetzten Ressourcen anzupassen, um eine zeitige Fertigstellung des Projekts zu erreichen. Die beschriebene Funktionalität soll in eine einfach bedienbare Webapplikation verbaut werden.
Die Projektdaten werden manuell kopiert und in diversen Excel-Dateien von Hand aufbereitet. Daraus werden dann von den Projekt Managern wöchentlich KPIs berechnet und ausgewertet, was einen sehr aufwändigen und fehleranfälligen Prozess darstellt. Während den letzten 10 Jahren hat sich nicht nur das eingesetzte Projektmanagement Tool stark verändert, sondern auch dessen Nutzung. Aus diesen Gründen sind die vorhandenen Daten stark heterogen und verfügen Über keine klare Struktur.
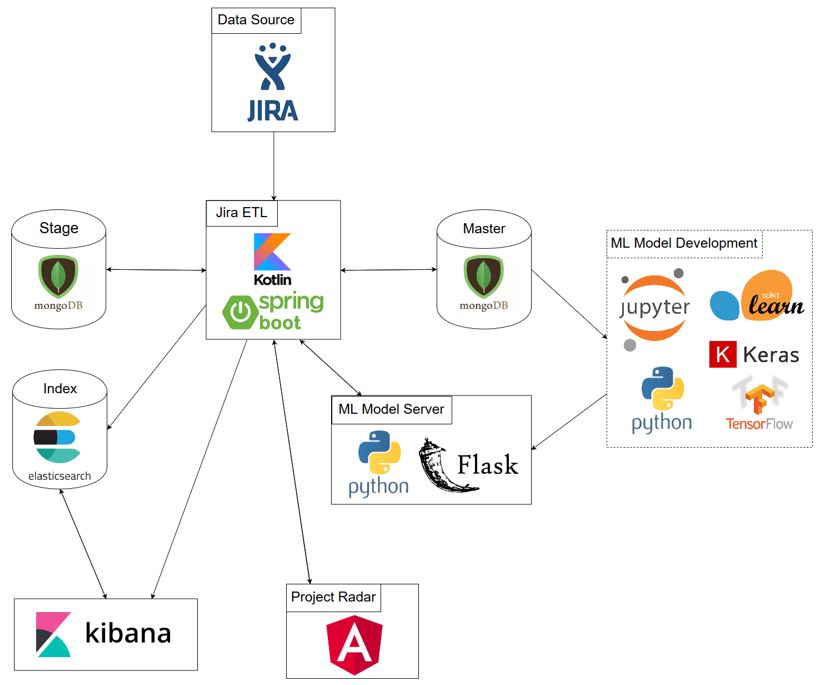
In einem ersten Schritt wurde ein Programm entwicklet, welches alle Projektdaten aus Jira automatisch extrahiert, aufbereitet und in einer zentralen Datenbank (MongoDB) für die weitere Verwendung zur Verfügung stellt. Mit Hilfe der Open-Source-Analyseplattform Kibana können detaillierte Analysen und Visualisierungen einfach erstellt werden. Weiter dient die Datenbasis als Quelle für die automatische Berechnung und Darstellung von KPIs sowie für die verschiedenen machine learning Modelle, welche im Wesentlichen folgende zwei Kern-Fragestellungen angehen:
Diverse Experimente haben gezeigt, dass für eine ausreichend genaue Beantwortung der zweiten Fragestellung weder die Grösse noch die Qualität beim Datensatz gegeben ist.
Aus diesem Grund wurde ein Simulationsalgorithmus geschrieben, welcher synthetische Projektdaten mit mimacom-Charakteristik generiert.
Mit Hilfe der so generierten Daten konnte gezeigt werden, dass sehr wohl geeignete machine learning Modelle existieren. Diese können aber erst produktiv eingesetzt werden, wenn mehr reale Daten vorhanden sind.
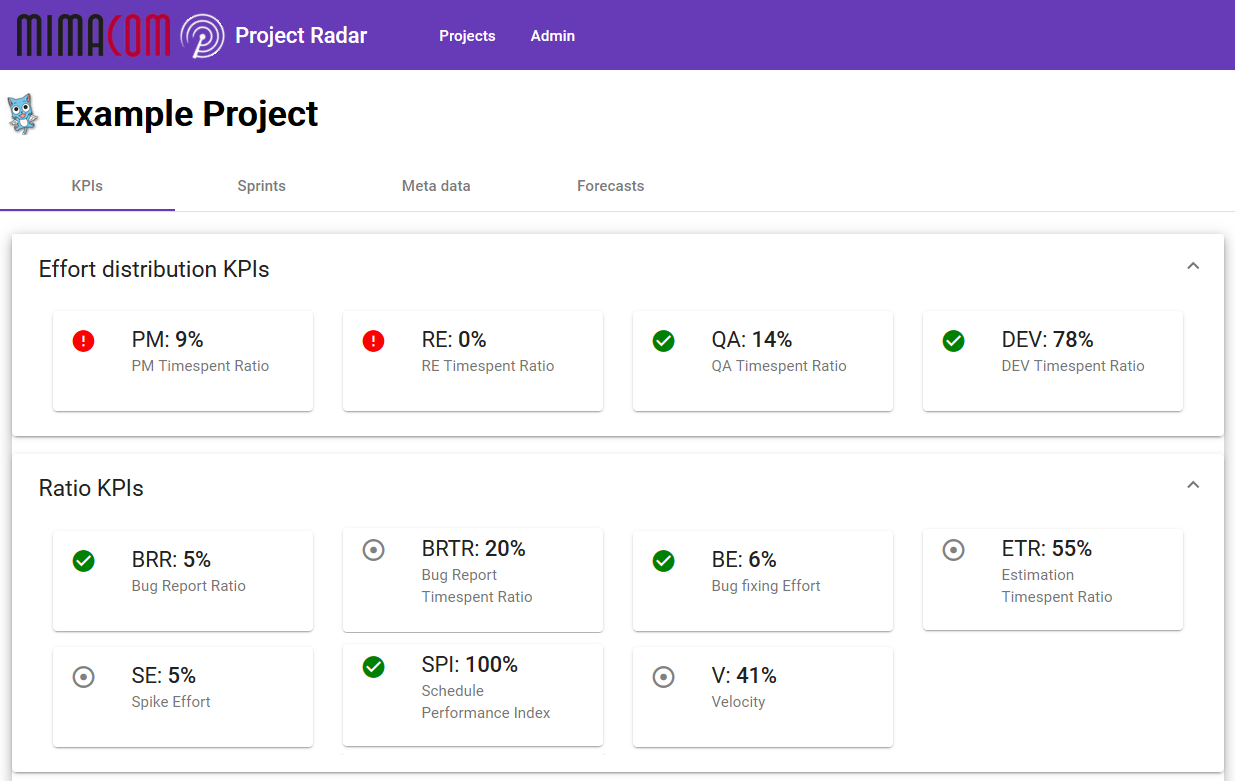
Letztendlich wurde eine Webapplikation erstellt, welche alle Projekte und deren KPIs auflistet und gleichzeitig Verwaltungsmöglichkeiten für Projekte bietet.
Zusätzlich bietet die Webapp direkte Anbindung an die Vorhersage-Modelle sowie Zugriff auf alle Funktionen zur erneuten Extraktion oder Transformation der Daten aus Jira.
Die gesamte Tool-Suite wurde nach Micro-Service Architektur aufgebaut und containerisiert in der Cloud aufgesetzt.
Projektdauer: 1 Semester, Aufwand in Personenstunden: 720h, Teamgrösse: 2, Bachelor Thesis
mimacom ag, vertreten durch Oliver Reinhard, Galgenfeldweg 16, CH-3006 Bern, 
Patric Steiner, Roger Obrist
Prof. Dr. Martin Melchior, martin.melchior@fhnw.ch, Institut für Data Science